NIST definiert eine Schwachstelle als eine Schwäche in einem Informationssystem, in Sicherheitsverfahren, internen Kontrollen oder der Implementierung, die von einer Bedrohungsquelle ausgenutzt oder ausgelöst werden kann. Diese Definition ist wichtig, weil sie weit mehr als fehlerhaften Code umfasst. Eine fehlkonfigurierte Firewall-Regel, ein unverändertes Standard-Administratorkennwort oder ein Geschäftsprozess, der Zugriffsüberprüfungen überspringt, fallen alle darunter.
Drei Maßnahmen, die Praktiker sofort ergreifen sollten:
- Priorisieren Sie anhand von CISA KEV und dem geschäftlichen Kontext. Reine CVSS-Werte geben Aufschluss über die technische Schwere; sie verraten Ihnen nicht, ob jemand die Schwachstelle aktiv gegen Systeme wie Ihre ausnutzt. Der CISA Known Exploited Vulnerabilities Catalog listet Schwachstellen auf, die nachweislich in der Praxis ausgenutzt werden, und ist der wirksamste Einzelfilter für dringende Behebungsentscheidungen.
- Nutzen Sie die maßgeblichen Kataloge. Das CVE-Programm vergibt autoritative Bezeichner für öffentlich bekannte Schwachstellen, die NVD reichert diese Einträge mit CVSS-Werten und Metadaten an, und CISA KEV kennzeichnet, welche davon aktiv ausgenutzt werden.
- Beobachten Sie Ihre Behebungszeit für öffentlich erreichbare, ausgenutzte Assets. Diese einzelne Kennzahl spiegelt mehr als jeder andere KPI wider, ob Ihr Programm mit den Angreiferzeitplänen in der realen Welt Schritt hält.
Inhaltsverzeichnis
- Welche Arten von Schwachstellen sollten Sicherheitsteams kennen?
- Wie werden Schwachstellen entdeckt, offengelegt und mit CVEs versehen?
- CVE, CVSS, NVD und CISA KEV: Was jedes System leistet und wie man es nutzt
- Der Schwachstellenlebenszyklus und ein praktischer Priorisierungs-Workflow
- Wie Teams Schwachstellen in der Praxis erkennen und bewerten
- Behebungsstrategien und wann nicht sofort gepatcht werden sollte
- KPIs und Governance-Kennzahlen, die zeigen, dass Ihr Programm funktioniert
- Wie Schwachstellenmanagement auf ISO 27001 und Ihr ISMS abbildet
- Wichtigste Erkenntnisse
- Die Lücke zwischen Schwachstellen-Scores und realen Risiken
- Ismscalculator hilft Ihnen bei der Planung und Budgetierung der Schwachstellenbehebung für ISO 27001
- Maßgebliche Ressourcen und Feeds, die jeder Praktiker überwachen sollte
Welche Arten von Schwachstellen sollten Sicherheitsteams kennen?
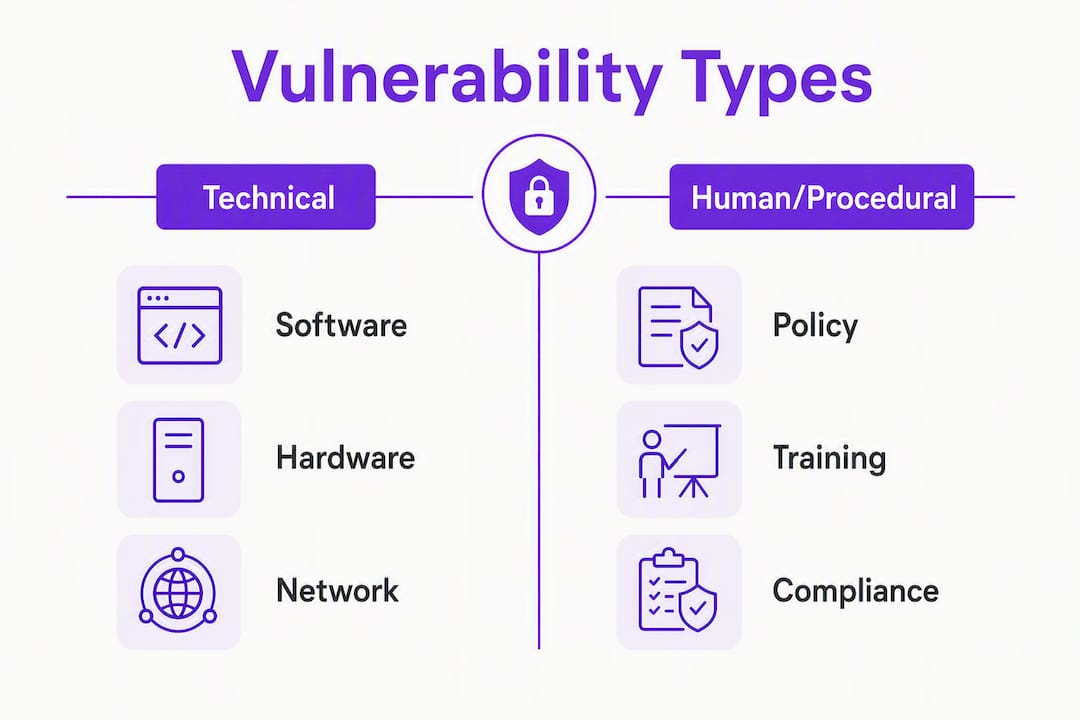
Sicherheitsteams haben es mit zwei großen Kategorien zu tun: technischen Schwachstellen und menschlichen bzw. verfahrensbedingten Schwachstellen. Diese Unterscheidung bestimmt, welche Erkennungsmethoden anwendbar sind und welche Behebungsmaßnahmen realistisch sind.
Technische Schwachstellen existieren in Software, Hardware, Firmware, Netzwerkinfrastruktur und Konfigurationen. Ein Speicherkorruptionsfehler in einem Webserver, eine nicht gepatchte Firmware-Version auf einem Netzwerk-Switch, eine zu freizügige S3-Bucket-Richtlinie – all das fällt in diese Kategorie. Die Erkennung ist weitgehend automatisierbar: Scanner, SCA-Tools und authentifizierte Konfigurationsprüfungen können die meisten davon in großem Umfang aufdecken.
Menschliche und verfahrensbedingte Schwachstellen sind schwieriger zu handhaben. Die NCSC-Leitlinien machen auf einen Punkt aufmerksam, den man verinnerlichen sollte: Eine sichere Implementierung kann dennoch anfällig sein, wenn Standardeinstellungen oder aktivierte Funktionen Angriffsflächen schaffen. Ein Entwickler, der den Debug-Modus in der Produktion aktiviert, ein Helpdesk-Team, das Passwörter zurücksetzt, ohne die Identität zu überprüfen, oder ein Onboarding-Prozess, der standardmäßig übermäßige Berechtigungen vergibt – all das ist in einem Portscan nicht sichtbar.
| Kategorie | Beispiel | Typische Erkennungsmethode |
|---|---|---|
| Software (Speicher-/Logikfehler) | Log4Shell | SAST, SCA, authentifizierter Scanner |
| Hardware/Firmware | Ungepatchtes BIOS/UEFI, CPU-Microcode-Fehler | Herstellerhinweise, Firmware-Scanner |
| Netzwerk/Protokoll | Exponiertes RDP, schwache TLS-Cipher-Suites | Netzwerkscanner, Protokollanalysator |
| Konfiguration | Standardzugangsdaten, offener Cloud-Speicher | CIS-Benchmark-Prüfungen, CSPM-Tools |
| Mensch/Verfahren | Schwacher Passwort-Reset-Prozess, übermäßige Zugriffserteilung | Prozessaudits, Zugriffsüberprüfungen, Phishing-Simulationen |
| Lieferkette/Drittanbieter | Anfällige Open-Source-Abhängigkeit | SCA (z. B. Dependabot, Snyk) |
Die obige Tabelle ist ein Ausgangspunkt für die Klassifizierung während der Triage. Die Kategorie bestimmt, welches Team für die Behebung zuständig ist und welche Art von Kontrolle die Lücke am schnellsten schließt.
Wie werden Schwachstellen entdeckt, offengelegt und mit CVEs versehen?
Der Weg von „jemand findet einen Fehler" bis „Ihr Scanner meldet ihn" umfasst mehrere Akteure und kann zwischen einigen Tagen und mehreren Monaten dauern.
Häufige Entdeckungsquellen:
- Unabhängige Sicherheitsforscher und Bug-Bounty-Jäger, die Meldungen an Hersteller oder CVE Numbering Authorities (CNAs) übermitteln
- Interne Sicherheitsteams der Hersteller und Product Security Incident Response Teams (PSIRTs)
- Sicherheitsanbieter und Threat-Intelligence-Firmen, die Schwachstellen bei der Incident-Response oder Produktforschung entdecken
- Interne Red Teams, Penetrationstester und Entwickler bei Code-Reviews oder Tests
- Automatisierte Fuzzing- und statische Analyse-Pipelines, die Grenzfälle im CI/CD-Prozess erkennen
Der Standard-Offenlegungsablauf:
- Ein Forscher identifiziert einen Fehler und kontaktiert den Hersteller oder eine CNA vertraulich.
- Der Hersteller validiert den Bericht, entwickelt einen Fix und koordiniert einen Offenlegungszeitplan (in der Regel 90 Tage nach den Standardnormen für verantwortungsvolle Offenlegung).
- Ein CVE-Bezeichner wird von einer CNA vergeben – entweder vom Hersteller selbst, von MITRE oder einer anderen autorisierten Organisation. Das CVE-Programm katalogisiert mittlerweile über 354.000 Einträge, was den Umfang öffentlich bekannter Schwachstellen widerspiegelt.
- Der Hersteller veröffentlicht gleichzeitig mit der CVE-Publikation einen Hinweis und einen Patch oder kurz danach.
- Die NVD übernimmt den CVE-Eintrag und reichert ihn mit CVSS-Werten, CWE-Klassifizierungen, CPE-Bezeichnern und Referenzlinks an – in der Regel innerhalb weniger Tage nach der CVE-Veröffentlichung, wobei die Anreicherungsverzögerung variieren kann.
- Nachgelagerte Feeds (SIEM-Integrationen, Scanner-Signatur-Updates, CISA KEV) übernehmen den Eintrag und leiten ihn in die Arbeitsabläufe der Verteidiger weiter.
Mehrere Variablen verkürzen oder verlängern diesen Zeitplan. Ein Zero-Day, der aktiv ausgenutzt wird, bevor ein Patch existiert, bricht das Fenster für koordinierte Offenlegung vollständig zusammen. Die Komplexität des Herstellers (ein Firmware-Update für eingebettete Hardware dauert länger zum Testen als ein Web-App-Patch) verlängert es. Wenn Exploit-Code öffentlich verfügbar ist, bevor ein Patch ausgeliefert wird, befinden sich Verteidiger in einem Wettlauf, den sie nicht gewählt haben.
Praktischer Überwachungsansatz: Abonnieren Sie CISA-Warnungen und den NVD-Datenfeed über API oder RSS. Erfassen Sie die PSIRTs der Hersteller für Ihren kritischen Software-Stack und konfigurieren Sie Benachrichtigungen. Leiten Sie CVE-Einträge direkt in Ihr Ticketing-System ein, damit neue Offenlegungen automatisch Triage-Aufgaben erstellen, anstatt in jemandem Posteingang zu verweilen.
CVE, CVSS, NVD und CISA KEV: Was jedes System leistet und wie man es nutzt
Diese vier Systeme werden häufig verwechselt. Sie erfüllen unterschiedliche Aufgaben, und ihre Verwechslung führt zu schlechten Priorisierungsentscheidungen.
CVE ist ein Bezeichner, mehr nicht. CVE-2023-44487 (HTTP/2 Rapid Reset) sagt Ihnen, um welchen Fehler es sich handelt, nicht wie schwerwiegend er ist oder ob ihn jemand ausnutzt. Das CVE-Programm, das über MITRE und ein Netzwerk von CNAs verwaltet wird, ist das maßgebliche Benennungssystem, das die gesamte Branche zur Vermeidung von Mehrdeutigkeiten verwendet.
CVSS (Common Vulnerability Scoring System), gepflegt von FIRST, bewertet die technische Schwere auf einer Skala von 0 bis 10 über drei Metrikgruppen: Basis (intrinsische technische Eigenschaften), Temporal (Exploit-Reife, Verfügbarkeit von Korrekturen) und Umgebung (Ihr spezifischer Einsatzkontext). Ein CVSS-Wert von 9,8 bedeutet, dass der Fehler unter ungünstigsten Annahmen technisch schwerwiegend ist. Das bedeutet nicht, dass Angreifer ihn derzeit gegen Ihre Branche einsetzen.
NVD (NIST National Vulnerability Database) ist die Anreicherungsschicht. Sie nimmt CVE-Einträge und ergänzt sie mit CVSS-Werten, CWE-Schwachstellenklassifizierungen, CPE-Produktbezeichnern und Referenzlinks. Die NVD ist die Quelle, aus der die meisten Scanner-Anbieter und SIEM-Plattformen strukturierte Schwachstellenmetadaten beziehen.
CISA KEV ist das Priorisierungssignal. Es listet Schwachstellen auf, die CISA als aktiv in der Praxis ausgenutzt bestätigt hat. Die Aufnahme in die KEV ist der stärkste Einzelindikator dafür, dass eine Schwachstelle sofortige Aufmerksamkeit erfordert, unabhängig vom CVSS-Wert.
| System | Was es bereitstellt | Primäre Verwendung in der Triage |
|---|---|---|
| CVE | Eindeutiger Bezeichner für eine offengelegte Schwachstelle | Referenz-ID für Nachverfolgung, Deduplizierung und Kommunikation |
| CVSS (FIRST) | Technischer Schweregrad (0–10), Basis/Temporal/Umgebung | Erster Schweregrad-Filter; niemals allein zur Priorisierung verwenden |
| NVD (NIST) | Angereicherte Metadaten: CVSS-Werte, CWE, CPE, Referenzen | Strukturierter Datenfeed für Scanner, SIEMs und Dashboards |
| CISA KEV | Bestätigte aktive Ausnutzung in der Praxis | Primärer Dringlichkeitsfilter; KEV = sofort beheben |
Praxistipp: Lassen Sie einen CVSS-Wert von 9,8 nicht automatisch an die Spitze Ihrer Warteschlange springen. Ein CVSS-Wert von 7,2, der in CISA KEV erscheint und ein öffentlich erreichbares System Ihrer Organisation betrifft, ist dringlicher. Behandeln Sie die KEV-Zugehörigkeit und die Asset-Kritikalität als primäre Treiber; verwenden Sie CVSS als sekundären Tiebreaker.
Der Schwachstellenlebenszyklus und ein praktischer Priorisierungs-Workflow
Eine Schwachstelle taucht nicht fertig mit einem Behebungsplan auf. Sie durchläuft Phasen, und Ihr Programm benötigt eine definierte Reaktion in jeder Phase.
Lebenszyklusphasen:
- Einführung – der Fehler gelangt in Ihre Umgebung (im Code ausgeliefert, durch Konfiguration aktiviert, über eine Drittanbieterkomponente eingeführt)
- Entdeckung – intern gefunden (Scan, Pentest, Code-Review) oder extern (CVE-Veröffentlichung, Threat-Intelligence-Feed)
- Offenlegung/CVE-Vergabe – öffentlicher Eintrag erstellt; Angreifer-Bewusstsein steigt
- Bewertung – Kontextualisierung gegenüber Ihrer Umgebung: Welche Assets sind betroffen, welche kompensierenden Kontrollen existieren, was ist die geschäftliche Auswirkung?
- Behebung – Patchen, Mitigieren oder Akzeptieren mit dokumentierter Begründung
- Verifizierung – Bestätigung, dass der Fix funktioniert; erneutes Scannen oder Testen
- Überwachung – Beobachtung auf Regression, neue Varianten oder verwandte CVEs
Die Bewertungsphase ist der Punkt, an dem die meisten Programme Zeit verlieren. NIST SP 800-40 betrachtet das Patchen als präventive Wartung, nicht als Ad-hoc-IT-Ticket – eine Sichtweise, die Teams zwingt, Zeit für die Kontextualisierung einzuplanen, anstatt jede neue CVE als Feuerwehreinsatz zu behandeln.
Priorisierungskriterien (in dieser Reihenfolge anwenden):
- KEV-Zugehörigkeit (aktive Ausnutzung bestätigt)
- Verfügbarkeit von öffentlichem Exploit-Code
- Asset-Kritikalität und geschäftliche Auswirkung
- Netzwerkexposition (internetorientiert vs. intern)
- Bereits vorhandene kompensierende Kontrollen
- Exploit-Komplexität (lokal vs. remote, Authentifizierung erforderlich)
- CVSS-Basiswert als Tiebreaker
Fünfstufiger Triage-Workflow:
- CVE-Eintrag aufnehmen; KEV-Zugehörigkeit sofort prüfen.
- Betroffene Assets gegen Ihr Inventar abgleichen; internetorientierte und geschäftskritische Systeme kennzeichnen.
- Ermitteln, ob kompensierende Kontrollen (WAF-Regel, Netzwerksegmentierung) die Exposition reduzieren können, während ein Patch vorbereitet wird.
- SLA-Kategorie und Verantwortlichen zuweisen; ein nachverfolgtes Behebungsticket erstellen.
- Nach dem Patchen erneut scannen oder testen, um den Abschluss zu bestätigen; Risikoregister aktualisieren.
Empfohlene SLA-Ziele:
- Notfall (KEV + öffentlich erreichbar): 48–72 Stunden
- Hoch (CVSS 7,0+ oder aktiver Exploit, internes kritisches System): 7–14 Tage
- Mittel (CVSS 4,0–6,9, kein aktiver Exploit): 30–90 Tage
- Niedrig (CVSS unter 4,0, kompensierende Kontrollen vorhanden): nächstes geplantes Wartungsfenster
Wenn Sie Ausnahmen gegenüber der Führungsebene darstellen, formulieren Sie diese als Restrisiko mit einer dokumentierten kompensierenden Kontrolle und einem zukünftigen Behebungsdatum. „Wir können diese Woche nicht patchen, da sich das System in einem Wartungseinfrierungszustand befindet; wir haben eine WAF-Regel angewendet und werden am [Datum] patchen" ist eine vertretbare Position. Schweigen ist es nicht.
Wie Teams Schwachstellen in der Praxis erkennen und bewerten
Kein einzelnes Tool deckt die gesamte Angriffsfläche ab. Effektive Erkennungsprogramme schichten Methoden und integrieren Ergebnisse in eine einheitliche Triage-Warteschlange.
Erkennungskategorien und ihre Kompromisse:
- Netzwerkscanner (nicht authentifiziert): Schnell, breite Abdeckung; erkennen keine Schwachstellen, die zur Erkennung eine Authentifizierung erfordern. Gut für die Überwachung externer Angriffsflächen.
- Authentifiziertes Scannen: Meldet sich bei Systemen an, um installierte Softwareversionen und Konfigurationen zu prüfen. Höhere Genauigkeit, höherer Verwaltungsaufwand für Zugangsdaten. Mindestens wöchentlich für kritische Assets durchführen.
- Software Composition Analysis (SCA): Identifiziert anfällige Open-Source-Abhängigkeiten im Anwendungscode. Tools wie Dependabot, Snyk oder OWASP Dependency-Check lassen sich direkt in CI/CD-Pipelines für kontinuierliche Abdeckung integrieren.
- SAST/DAST: Statische Analyse erkennt Fehler auf Code-Ebene vor der Bereitstellung; dynamische Analyse testet laufende Anwendungen auf Injection-, Authentifizierungs- und Logikfehler. Keines der beiden ersetzt das andere.
- Fuzzing: Automatisierte Eingabemutation zur Erkennung von Abstürzen und unerwartetem Verhalten. Besonders effektiv für Parser, APIs und Protokollimplementierungen. Erfordert anfänglich Engineering-Aufwand, skaliert aber gut, wenn einmal instrumentiert.
- Manuelle Code-Reviews und Penetrationstests: Hohes Signal, geringe Häufigkeit. Pentests sind episodisch (in der Regel jährlich oder nach größeren Änderungen); sie decken Logikfehler und verkettete Angriffspfade auf, die automatisierte Tools übersehen.
- Laufzeit-Erkennung (EDR/SIEM): Erkennt laufende Ausnutzungsversuche. Kein Präventionsinstrument, aber unerlässlich, um zu erkennen, wann eine Schwachstelle in Ihrer Umgebung aktiv anvisiert wird.
Die praktische Herausforderung ist das Rauschen. Authentifizierte Scanner in einem großen Netzwerk produzieren Tausende von Befunden pro Woche, von denen viele False Positives oder bereits behobene Probleme sind. Dieses Rauschen zu reduzieren erfordert drei Dinge: Normalisierung der Befunde über Tools hinweg in ein einheitliches Schema, Deduplizierung nach CVE und Asset sowie Abgleich mit Ihrem Asset-Inventar, um bereits gepatchte oder isolierte Systeme herauszufiltern.
Praxistipp: Bevor Sie einen Scanner-Befund direkt in ein Behebungsticket überführen, validieren Sie ihn in einer Staging-Umgebung, die der Produktion entspricht. Ein Befund, der in der Staging-Umgebung ein False Positive auslöst, erspart Ihnen einen Rollback um Mitternacht in der Produktion. Korrelieren Sie Scanner-Ausgaben mit Threat-Intelligence-Feeds, um theoretische Exposition von aktiver Bedrohung zu trennen.
Behebungsstrategien und wann nicht sofort gepatcht werden sollte
Sofortiges Patchen ist meistens die richtige Antwort. Es ist nicht immer betrieblich sicher, und so zu tun, als ob, führt entweder zu blinden Rollouts, die die Produktion beschädigen, oder zu unbefristeten Verzögerungen ohne kompensierende Kontrolle.
Entscheidungsablauf:
- Sofort patchen, wenn ein sicherer, getesteter Patch existiert, das System ein Wartungsfenster verkraften kann und die Schwachstelle in der KEV gelistet oder CVSS 9,0+ ist.
- Stufenweise Einführung, wenn der Patch verfügbar ist, das System aber geschäftskritisch ist. Validieren Sie in einer Nicht-Produktionsumgebung, die der Produktion entspricht, stellen Sie für eine kleine Canary-Gruppe bereit, messen Sie Stabilität und Telemetrie und fahren Sie dann mit der breiteren Produktion fort. Best Practices für stufenweise Einführungen erfordern geübte Rollback-Pläne, bevor eine Canary-Bereitstellung beginnt.
- Virtuelles Patchen, wenn noch kein Patch existiert oder das System nicht gepatcht werden kann, ohne inakzeptable Ausfallzeiten zu verursachen. Eine WAF-Regel oder IPS-Signatur, die den Angriffsvektor blockiert, verschafft Zeit. NIST SP 1800-31 dokumentiert virtuelles Patchen als legitime Überbrückung für Legacy-Systeme, mit einem wichtigen Vorbehalt: Virtuelle Fixes müssen Ablaufrichtlinien und Überwachung haben, damit sie nicht zu dauerhafter, undokumentierter technischer Schuld werden.
- Netzwerksegmentierung/Isolierung, wenn das betroffene System hinter eine strengere Netzwerkgrenze verschoben werden kann, wodurch der Ausstrahlungsradius reduziert wird, auch wenn die Schwachstelle ungepacht bleibt.
- Vorübergehende Kontodeaktivierung oder Zugriffsbeschränkung für Schwachstellen, die authentifizierten Zugang zur Ausnutzung erfordern.
- Risikoakzeptanz mit Überwachung als letztes Mittel, dokumentiert mit einem benannten Verantwortlichen, einer kompensierenden Kontrolle und einem Überprüfungsdatum.
Kompensierende Kontrollen mit Implementierungshinweisen:
- Netzwerksegmentierung: Anfällige Systeme in ein eingeschränktes VLAN verschieben; Firewall-ACLs aktualisieren, um eingehende Verbindungen auf erforderliche Ports und Quell-IPs zu beschränken.
- WAF-Regeln: Herstellerspezifische oder benutzerdefinierte Regeln einsetzen, die auf das Exploit-Muster abzielen; vor dem Blockierungsmodus im Erkennungsmodus testen.
- IPS-Signaturen: Signaturen für bekannte Exploit-Muster aktivieren; vor dem Produktiveinsatz abstimmen, um False Positives zu reduzieren.
- MFA-Durchsetzung: Bei Schwachstellen zur Authentifizierungsumgehung erhöht die Durchsetzung von MFA für den betroffenen Dienst die Hürde für die Ausnutzung, auch ohne Patch.
- Reduzierte Netzwerkexposition: Nicht benötigte Dienste deaktivieren, ungenutzte Ports schließen und öffentlich zugänglichen Zugang für Systeme entfernen, die ihn nicht benötigen.
Praxistipp: Wenn Sie der Führungsebene Behebungskosten präsentieren, stellen Sie diese den Kosten eines Sicherheitsvorfalls gegenüber, nicht nur den Engineering-Stunden. Ein zweitägiges Patch-Fenster für eine KEV-gelistete Schwachstelle auf einem Zahlungsverarbeitungssystem ist weitaus günstiger als die Incident-Response-, Meldepflicht- und Reputationskosten einer Ausnutzung. Eine einseitige Behebungskurzinfo mit drei Feldern – Schwachstelle, geschäftliches Risiko ohne Patch, vorgeschlagener Fix und Zeitplan – erhält schneller Genehmigungen als ein technisches Ticket.
KPIs und Governance-Kennzahlen, die zeigen, dass Ihr Programm funktioniert
Kennzahlen sind wichtig, weil Sicherheitsverantwortliche damit den Programmzustand gegenüber Führungskräften und Vorständen belegen und weil sie aufzeigen, wo das Programm tatsächlich versagt, bevor es ein Angreifer tut.
Zu verfolgende KPIs:
- Mean Time to Remediate (MTTR): Durchschnittliche Zeit von der Entdeckung einer Schwachstelle bis zur verifizierten Behebung. Getrennt für KEV-gelistete und Nicht-KEV-Befunde verfolgen; der Gesamtwert verbirgt den langen Schwanz.
- Asset-Abdeckung: Prozentsatz der bekannten Assets, die in den letzten 30 Tagen gescannt wurden. Eine Abdeckung unter 90 % bedeutet, dass Sie blinde Flecken haben.
- KEV-Behebungsrate innerhalb der SLA: Prozentsatz der CISA KEV-gelisteten Schwachstellen, die Ihre Umgebung betreffen und innerhalb Ihres Notfall-SLA-Fensters behoben wurden. Dies ist die Kennzahl, nach der Regulierungsbehörden und Prüfer zunehmend fragen.
- Altersverteilung des Rückstands: Wie alt sind Ihre offenen Befunde? Ein hoher Anteil von Befunden, die älter als 90 Tage sind, signalisiert einen systemischen Behebungsengpass, nicht nur ein Kapazitätsproblem.
- False-Positive-Rate: Hohe False-Positive-Raten untergraben das Vertrauen der Ingenieure in Scanner-Ergebnisse und verlangsamen die Triage. Verfolgen und abstimmen.
- Patch-Erfolgsrate: Prozentsatz der ohne Rollback oder Vorfall angewendeten Patches. Niedrige Raten weisen auf Testlücken hin.
NIST SP 800-40 betrachtet Schwachstellenmanagement als präventive Wartung, was bedeutet, dass diese Kennzahlen in operative Dashboards gehören, zusammen mit Verfügbarkeit und Vorfallzahlen, und nicht in einem vierteljährlichen Sicherheitsbericht begraben werden sollten.
Governance-Rhythmus:
- Wöchentlich: Behebungsüberprüfung für KEV- und Notfallbefunde
- Monatlich: Rückstandsüberprüfung, SLA-Compliance-Bericht, Ausnahmenprotokoll-Überprüfung
- Vierteljährlich: Führungsdashboard-Update, KPI-Trendanalyse des Programms, Ausnahmengenehmigungen für langfristige Verzögerungen
Praxistipp: Vermeiden Sie es, den durchschnittlichen MTTR als Ihre Hauptkennzahl zu berichten. Ein Mittelwert von 14 Tagen sieht gesund aus, bis Sie erkennen, dass 20 % Ihrer Befunde 180+ Tage alt sind. Berichten Sie den MTTR als Verteilung oder beim 90. Perzentil. Das ist die Zahl, die zeigt, ob Ihr Programm die schwierigen Fälle bewältigt, nicht nur die einfachen.
Wie Schwachstellenmanagement auf ISO 27001 und Ihr ISMS abbildet
Schwachstellenmanagement ist kein eigenständiges Programm. Unter ISO 27001 bildet es direkt auf Annex-A-Kontrollen ab und fließt in den ISMS-Risikobehandlungsplan ein. Die richtige Abbildung ist das, was Scanner-Ergebnisse in Prüfungsnachweise verwandelt.
| Schwachstellenaktivität | ISO 27001 Klausel/Kontrolle | Empfohlenes Deliverable |
|---|---|---|
| Asset-Erkennung und -Inventar | — | Gepflegtes Asset-Register mit Scan-Abdeckungsnachweisen |
| Authentifiziertes Scannen und Konfigurationsprüfungen | — | Scan-Berichte, Konfigurationsbaseline-Aufzeichnungen |
| Risikobasierte Priorisierungsentscheidungen | — | Risikoregister-Einträge mit dokumentierter Priorisierungsbegründung |
| Patch-Anwendung und -Verifizierung | — | Change-Tickets, Neuscan-Ergebnisse, Patch-Erfolgsnachweise |
| Kompensierende Kontrollen und Risikoakzeptanz | — | Risikoakzeptanz-Aufzeichnungen mit benanntem Verantwortlichen und Überprüfungsdatum |
| Kontinuierliche Überwachung und Kennzahlen | — | KPI-Dashboards, Ausnahmenprotokolle, Governance-Meeting-Protokolle |
ISO 27001 und CISA-KEV-basierte Priorisierung passen gut zusammen: Beide erfordern eine dokumentierte, risikobasierte Priorisierung statt der Jagd nach rohen CVSS-Werten. Die praktische Konsequenz ist, dass Ihre Behebungstickets festhalten müssen, warum eine Schwachstelle priorisiert oder zurückgestellt wurde, nicht nur dass sie es wurde.
Praktische Schritte für die ISMS-Bereitschaft im Bereich Schwachstellenmanagement:
- Pflegen Sie ein dokumentiertes IT-Asset-Inventar als Grundlage für Scan-Abdeckung und Priorisierung.
- Dokumentieren Sie Ihre Priorisierungsmethodik (KEV + Asset-Kritikalität + kompensierende Kontrollen), damit Prüfer Ihrer Argumentation folgen können.
- Bewahren Sie Behebungsnachweise auf: abgeschlossene Tickets, Neuscan-Ergebnisse, Konfigurations-Snapshots und Change-Records.
- Ordnen Sie kompensierende Kontrollen den Annex-A-Kontrollen zu und nehmen Sie sie in den Risikobehandlungsplan auf.
- Planen Sie regelmäßige Management-Reviews des Schwachstellenrückstands als Teil der ISMS-Governance.
Die Budgetierung und Terminierung dieser Arbeit ist der Punkt, an dem die meisten Teams scheitern. Die Abschätzung des Aufwands, einen Rückstand von 500 Einträgen über die vier Annex-A-Kontrollthemen zu schließen und gleichzeitig kontinuierliches Scannen und Beweiserhebung aufrechtzuerhalten, erfordert mehr als eine Tabellenkalkulation. Ein Planungstool, das Ihre Sicherheitsreife über ISO-Domänen hinweg abbildet und Zeit- und Kostenschätzungen erstellt, gibt Compliance-Beauftragten und IT-Managern etwas Konkretes für Budgetgespräche an die Hand.
Wichtigste Erkenntnisse
Effektives Schwachstellenmanagement behandelt Belege für aktive Ausnutzung – insbesondere die KEV-Zugehörigkeit bei CISA – als primäres Priorisierungssignal, vor CVSS-Werten, um den Behebungsaufwand dort zu konzentrieren, wo Angreiferaktivität bestätigt ist.
| Punkt | Details |
|---|---|
| KEV als primären Filter verwenden | KEV-Zugehörigkeit signalisiert bestätigte aktive Ausnutzung; KEV-gelistete, öffentlich erreichbare Assets innerhalb von 48–72 Stunden beheben. |
| Nicht allein auf CVSS verlassen | CVSS misst die technische Schwere, nicht die aktive Ausnutzung; kombinieren Sie ihn mit Asset-Kritikalität und Geschäftskontext für eine vertretbare Priorisierung. |
| Virtuelles Patchen verschafft Zeit, keine Dauerlösung | WAF/IPS-kompensierende Kontrollen sind legitime Überbrückungen für Legacy-Systeme, erfordern aber Ablaufrichtlinien und Überwachung, um keine dauerhafte Schuld zu werden. |
| MTTR als Verteilung verfolgen | Die Berichterstattung über den durchschnittlichen MTTR verbirgt langfristige Hochrisikopositionen; verwenden Sie Kennzahlen beim 90. Perzentil, um systemische Behebungsengpässe aufzudecken. |
| Ismscalculator für ISO-27001-Planung | Ismscalculator bildet Schwachstellenmanagement-Aktivitäten auf ISO-27001-Klauseln ab, schätzt Aufwand und Kosten und erstellt prüfungsbereite Artefakte über 14 ISMS-Domänen. |
Die Lücke zwischen Schwachstellen-Scores und realen Risiken
Die meisten Organisationen, die ich beim Schwachstellenmanagement scheitern sehe, haben ein gemeinsames Problem: Sie haben ihr Programm auf CVSS-Werte aufgebaut, weil Werte leicht zu berichten sind. Ein Dashboard voller 9,8er sieht wie eine klare Prioritätenliste aus. Das Problem ist, dass CVSS dazu entwickelt wurde, die technische Schwere unter ungünstigsten Annahmen zu messen, nicht um widerzuspiegeln, was Angreifer tatsächlich in Ihrer Branche diese Woche tun.
Der Wandel, der Programmergebnisse verändert, besteht darin, Schwachstellenmanagement als kontinuierliche Risikodisziplin zu behandeln und nicht als Patch-Warteschlange. Das bedeutet, andere Fragen zu stellen: Ist dieser Fehler in CISA KEV? Deuten meine Threat-Intelligence-Hinweise auf aktives Targeting dieser Software in meiner Branche hin? Befindet sich das betroffene System hinter kompensierenden Kontrollen, die die Exposition sinnvoll reduzieren? Diese Fragen erfordern Urteilsvermögen, nicht nur einen Score-Schwellenwert.
Das andere, was Praktiker unterschätzen, ist die organisatorische Seite. Ein technisch fundiertes Priorisierungsframework scheitert, wenn Ingenieure dem Scanner-Output nicht vertrauen, wenn die Führungsebene keine Wartungsfenster genehmigt oder wenn der Behebungsrückstand keinen Verantwortlichen hat. Das Patchen als präventive Wartung zu rahmen – wie NIST SP 800-40 empfiehlt – verändert das Budget-Gespräch. Wartung hat einen Budgetposten. Notfallreaktion hat keinen, bis sie es hat.
Für Teams, die sich auf ISO 27001 vorbereiten, lohnt es sich, den Compliance-Leitfaden für Schwachstellenmanagement zusammen mit diesem Artikel zu lesen. Die Abbildung zwischen täglichen operativen Aktivitäten und Prüfungsnachweisen ist der Bereich, in dem die meisten Programme Lücken haben, und diese Lücken vor einer Prüfung zu schließen ist weitaus weniger schmerzhaft als sie während einer Prüfung zu entdecken.
Ismscalculator hilft Ihnen bei der Planung und Budgetierung der Schwachstellenbehebung für ISO 27001
Zu wissen, was zu beheben ist, ist ein Problem. Zu wissen, was es kostet, wie lange es dauert und welche Nachweise Prüfer verlangen werden, ist ein ganz anderes.

Ismscalculator ist ein Planungs- und Bereitschaftstool, das für Compliance-Beauftragte, IT-Manager und Führungskräfte entwickelt wurde, die die ISO-27001-Implementierung navigieren. Es ist kein Scanner und kein Behebungsanbieter. Was es tut, ist, Ihre Sicherheitsreife über die vier Annex-A-Kontrollthemen hinweg in eine umfangreiche Kostenschätzung, einen anpassbaren Implementierungszeitplan und die Artefakt-Checkliste zu übersetzen, die Prüfer erwarten. Sie können Ihren Plan mit Referenzwerten vergleichen, mehrere Szenarien speichern und vergleichen sowie einen PDF-Bericht exportieren, um ihn in ein Budget-Meeting zu bringen.
Für Teams am Anfang dieses Prozesses bietet die kostenlose 2-minütige Bereitschafts-Selbstbewertung sofort eine Baseline über die ISO-27001-Domänen, die für das Schwachstellenmanagement am relevantesten sind. Wenn Sie externe Unterstützung benötigen, verbindet Sie das unabhängige Beraterverzeichnis mit ISO-27001-Implementierern und leitenden Auditoren, die den Aufwand zusammen mit Ihrem internen Team abschätzen können.
Maßgebliche Ressourcen und Feeds, die jeder Praktiker überwachen sollte
Dies sind die primären Quellen für Schwachstellendaten, Bewertungsleitlinien und Compliance-Frameworks. Jede verfügt über eine empfohlene Nutzungsmethode für Teams, die automatisierte Triage-Pipelines aufbauen.
-
NVD (NIST National Vulnerability Database): Die maßgebliche Quelle für angereicherte CVE-Einträge einschließlich CVSS-Werte, CWE-Klassifizierungen und CPE-Bezeichner. Über die NVD-REST-API (JSON-Feeds) für SIEM-Einspeisung oder Scanner-Anreicherung nutzen. Ratenlimitiert; für Produktionsintegrationen einen API-Schlüssel verwenden.
-
CISA Known Exploited Vulnerabilities Catalog: Der primäre Filter für dringende Behebungen. Als kontinuierlich aktualisierter JSON-Feed verfügbar. CISA-Warnungen abonnieren und den KEV-JSON in Ihr Ticketing-System integrieren, um KEV-gelistete CVEs in Ihrer Umgebung automatisch zu kennzeichnen.
-
CVE-Programm: Das maßgebliche Bezeichnerregister. CVE-IDs als Primärschlüssel für die Deduplizierung über Tools hinweg verwenden. Der Datenfeed des CVE-Programms ist im JSON-Format verfügbar und lässt sich in die meisten kommerziellen und Open-Source-Schwachstellenmanagementplattformen integrieren.
-
FIRST CVSS-Dokumentation: FIRST veröffentlicht die CVSS-Spezifikation, den Scoring-Rechner und Leitlinien zur Anwendung von Umgebungsmetriken auf Ihren spezifischen Einsatzkontext. Den Umgebungswert verwenden, nicht nur den Basiswert, wenn die Schwere gegenüber Stakeholdern berichtet wird.
-
NIST-Schwachstellenleitlinien (CSRC): NISTs Computer Security Resource Center veröffentlicht SP 800-40 (Patch- und Schwachstellenmanagement), das Schwachstellenglossar und Framework-Leitlinien. Pflichtlektüre für Programm-Governance und Richtliniendokumentation.
Integrationshinweis: Die effektivsten Triage-Pipelines nehmen NVD- und KEV-Feeds über API auf, normalisieren CVE-Einträge gegenüber dem Asset-Inventar und erstellen automatisch Tickets, wenn eine neue CVE einem bekannten Asset entspricht. Eine KEV-Zugehörigkeitsprüfung als Ticketfeld hinzuzufügen – mit einer automatischen Eskalationsregel für KEV + internetorientierte Assets – reduziert die Zeit zwischen CVE-Veröffentlichung und Behebungszuweisung von Tagen auf Minuten.
Empfohlen
- Schwachstellenmanagement im ISMS: Ein Compliance-Leitfaden | ISMS Calculator
- Die Rolle des Penetrationstests im ISMS: Ein Compliance-Leitfaden | ISMS Calculator
- ISO 27001 Anwendbarkeitserklärung: Ein vollständiger Leitfaden | ISMS Calculator
- ISO 27001 Risikobewertung: Ein vollständiger Methodikleitfaden | ISMS Calculator