La gestión de incidentes en ISO 27001 se sustenta en cinco controles del Annex A, del 5.24 al 5.28, más el requisito de notificación por parte del personal recogido en el control 6.8. Un programa conforme necesita un Equipo de Gestión de Incidentes designado, una matriz de severidad documentada, al menos un playbook probado y registros de evidencias con una cadena de custodia defendible. Los auditores no se conforman con políticas: quieren demostrar que el ciclo completo desde la detección hasta las lecciones aprendidas se cierra realmente.
Resumen ejecutivo:
- Contar con un equipo de gestión de incidentes documentado, con autoridad clara y delegación de funciones, es esencial para un cumplimiento efectivo de ISO 27001.
- Las organizaciones deben establecer un proceso de clasificación de severidad medible para garantizar una toma de decisiones y una escalada ágiles dentro de los plazos establecidos.
- La recopilación de evidencias, incluidos registros e instantáneas de memoria, debe planificarse con antelación y contar con una cadena de custodia para evitar la pérdida de datos durante la respuesta al incidente.
- Los ejercicios de simulación y los incidentes reales son fundamentales para probar el ciclo completo, desde la detección hasta las lecciones aprendidas, no solo la documentación de políticas.
- El uso de herramientas de evaluación permite identificar rápidamente las carencias en la preparación para la gestión de incidentes, asegurando la disposición antes de que ocurra un incidente real.
Tabla de Contenidos
- ¿Qué cubre la gestión de incidentes en ISO 27001?
- Los cinco controles de gestión de incidentes, explicados control por control
- ¿Quién dirige el Equipo de Gestión de Incidentes?
- ¿Cómo se clasifica la severidad de los incidentes?
- Contención, erradicación, recuperación y comunicación paralela
- Recopilación de evidencias sin ralentizar la respuesta
- Convertir los incidentes en mejoras del SGSI
- ¿Qué solicitan los auditores durante las pruebas?
- Cómo ISMS Calculator acelera la preparación para la gestión de incidentes
- Perspectiva del autor: la gestión de incidentes como programa iterativo
- Inicie su comprobación de preparación para la gestión de incidentes en ISO 27001
- Fuentes
¿Qué cubre la gestión de incidentes en ISO 27001?
Los marcos de seguridad de la información establecen una distinción clara entre un "evento" y un "incidente". Un evento es cualquier ocurrencia observada en un sistema, red o servicio. La mayoría de los eventos son ruido: un inicio de sesión fallido, un escaneo de puertos bloqueado, un archivo adjunto de correo electrónico marcado como sospechoso. Un incidente es un evento (o serie de eventos) que compromete la confidencialidad, la integridad o la disponibilidad con consecuencias reales para el negocio. Esta distinción es importante porque determina en qué momento se activa el mecanismo de gestión de incidentes.
ISO/IEC 27001:2022 sitúa los requisitos de gestión de incidentes en el Annex A, controles 5.24 a 5.28, con un control de apoyo en el punto 6.8 referente a la notificación por parte del personal. Estos cinco controles se diferencian de los controles preventivos que dominan la mayor parte del Annex A —control de acceso, criptografía, segmentación de redes— porque parten de la premisa de que algo ya ha salido mal. Los controles preventivos intentan apagar el fuego antes de que prenda. Los controles de gestión de incidentes indican qué hacer en el momento en que ya hay humo en la sala.
Se trata de una elección estructural deliberada. Un conjunto de reglas de firewall y un playbook de incidentes resuelven problemas distintos: uno reduce la probabilidad de una brecha, el otro rige lo que ocurre en el momento en que esa probabilidad no se sostiene. Las organizaciones que tratan la gestión de incidentes como una extensión de sus controles técnicos tienden a redactar playbooks que nadie sigue, porque los controles parecen arquitectura de seguridad en lugar de un manual operativo.
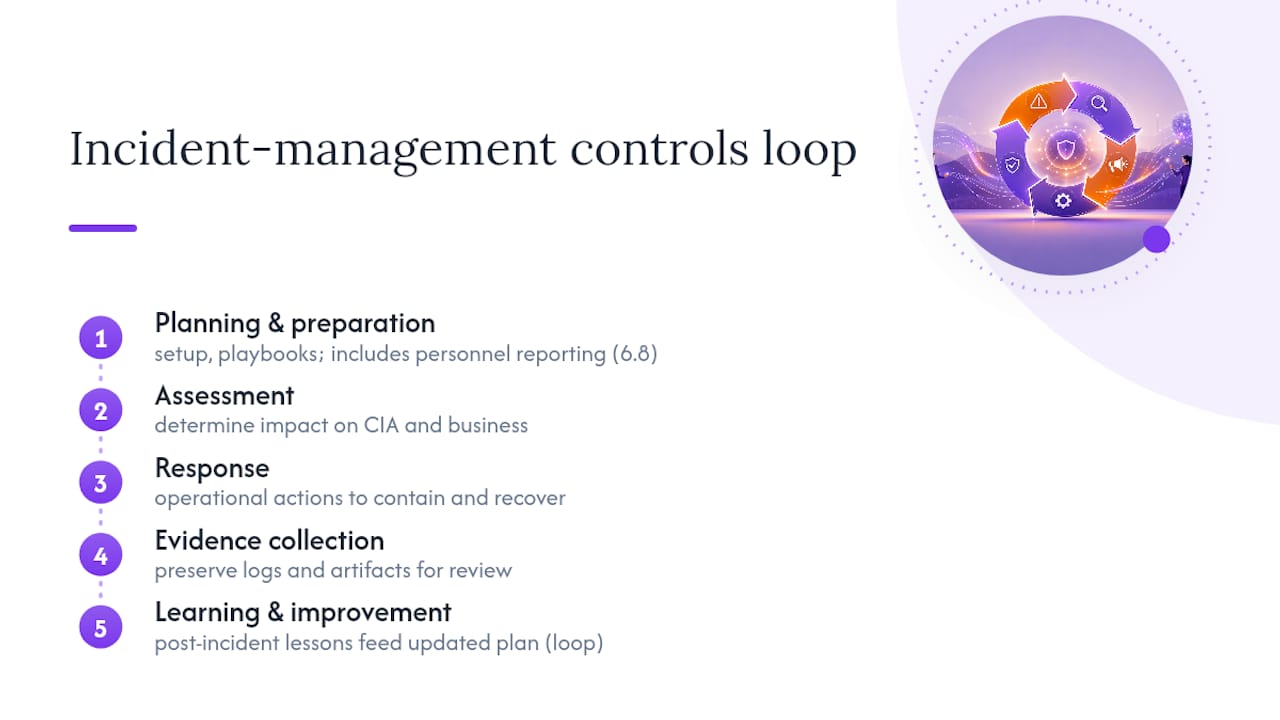
Los cinco controles forman un ciclo, no una lista de verificación. La planificación y la preparación alimentan la evaluación; la evaluación alimenta la respuesta; la respuesta alimenta la recopilación de evidencias; y la recopilación de evidencias alimenta el aprendizaje, que a su vez actualiza el plan. La guía para profesionales sobre el conjunto de controles de gestión de incidentes enmarca este ciclo como lo que los auditores realmente comprueban, a menudo repasando un incidente real o un ejercicio de simulación en lugar de leer documentos de forma aislada. Un archivador lleno de textos de política sin ninguna evidencia de que el ciclo se haya ejecutado alguna vez es el hallazgo más frecuente en las auditorías de seguimiento.
Los cinco controles de gestión de incidentes, explicados control por control
Cada control se corresponde con una fase diferenciada del ciclo de vida del incidente, y cada uno genera un artefacto específico que el auditor solicitará ver. Omitir el artefacto, incluso cuando la actividad subyacente tuvo lugar, equivale funcionalmente a omitir el control.
5.24, Planificación y preparación de la gestión de incidentes. Este control exige una política documentada que defina qué se considera un incidente, quién tiene autoridad para declararlo y cómo responderá la organización. Es la base sobre la que se construye todo lo demás.
- Un Equipo de Gestión de Incidentes (EGI) designado con funciones definidas
- Playbooks escritos para escenarios habituales (ransomware, exposición de datos, denegación de servicio, uso indebido por parte de personal interno)
- Canales de comunicación y rutas de escalada, incluidos contactos fuera del horario laboral
- Plantillas preaprobadas para actualizaciones internas, notificaciones a reguladores y comunicaciones a clientes
5.25, Evaluación y decisión. Una vez que algo se señala como sospechoso, alguien debe decidir rápidamente si se trata de un incidente real y cuál es su severidad. Este control exige un método de clasificación repetible, no un juicio elaborado desde cero en cada ocasión.
- Registrar el evento desencadenante con una marca de tiempo y la fuente
- Aplicar una clasificación de severidad (se detalla más adelante)
- Decidir si se declara formalmente un incidente
- Registrar la decisión y el tiempo empleado en alcanzarla
5.26, Respuesta. Este es el núcleo operativo: contener el problema, eliminar la causa, restaurar el servicio normal e informar a las partes interesadas en todo momento. Los auditores esperan constatar que las medidas de contención no esperaron a un análisis completo de la causa raíz. En las primeras horas, la velocidad importa más que la exhaustividad.
5.27, Aprendizaje de los incidentes. Cada incidente cerrado debería generar una revisión breve: qué ocurrió, por qué y qué cambiará. Este control es donde un programa o bien acumula madurez o bien se estanca. Las organizaciones que omiten este paso acaban reproduciendo el mismo incidente, a veces con la misma causa raíz, un año después.
5.28, Recopilación de evidencias. Los registros, capturas de pantalla, volcados de memoria y registros de comunicaciones necesitan una cadena de custodia documentada desde el momento en que se recopilan. Esto importa incluso cuando la litigiosidad parece improbable en el momento del incidente, porque esa suposición resulta frecuentemente errónea en retrospectiva.
El texto de las cláusulas en la edición de 2022 es deliberadamente escueto en cuanto a la prescripción de herramientas o formatos concretos. Esa flexibilidad es una ventaja para las organizaciones que ya gestionan un sistema maduro de gestión de servicios de TI, y una trampa para las que interpretan "flexible" como "opcional". La guía de controles del Annex A de Ismscalculator explica cómo estos cinco controles se relacionan con el resto del Annex A si necesita una visión más amplia.
¿Quién dirige el Equipo de Gestión de Incidentes?
Un EGI que solo existe en un organigrama es peor que no tener ninguno, porque proporciona a los auditores un documento en el que encontrar fallos. El equipo necesita personas nominadas, autoridad definida y un proceso de traspaso documentado para cuando el contacto principal no está disponible.
Un EGI funcional incluye habitualmente:
- Responsable del incidente — es el titular de la decisión de declarar, escalar o cerrar un incidente, y coordina todos los demás roles durante la respuesta activa
- Responsable técnico — dirige las labores de contención y erradicación en los sistemas, incorporando ingenieros especialistas según sea necesario
- Responsable de comunicaciones — redacta y revisa las actualizaciones internas, los avisos a clientes y los comunicados de prensa antes de que se envíen
- Representante legal o de cumplimiento normativo — decide cuándo se involucra a asesoría externa o a especialistas forenses, y hace seguimiento de las obligaciones de notificación a reguladores
- Representante de RRHH o de personas — gestiona los casos relacionados con amenazas internas, conducta indebida de empleados o seguimiento disciplinario
La autoridad es el aspecto que las organizaciones documentan insuficientemente. ¿Puede el responsable técnico aislar un servidor en producción sin abrir un ticket de gestión del cambio? ¿Puede el responsable del incidente autorizar una notificación a clientes antes de que el área legal dé el visto bueno, si la velocidad es más importante que la forma? Estas respuestas deben figurar en el propio plan, no en la memoria de alguien sobre "cómo solemos manejarlo".
Documente la delegación de autoridad del mismo modo que documentaría cualquier otro control: persona nominada, ámbito de autoridad, fecha de entrada en vigor y una firma o registro en el sistema que acredite el reconocimiento. Complemente esto con registros de formación que demuestren que cada miembro del EGI ha participado en al menos un ejercicio de simulación en su función. Los auditores solicitan ambos, y un equipo con autoridad pero sin evidencia de formación parece casi tan poco preparado como uno que carece de ambas.
¿Cómo se clasifica la severidad de los incidentes?
El control 6.8 exige que las organizaciones proporcionen al personal un método claro y sencillo para notificar eventos de seguridad sospechosos. Si notificar requiere tres aprobaciones y un ticket en un sistema cuyas credenciales nadie recuerda, el personal no notificará, y todo el ciclo de gestión de incidentes se agotará en el origen. Los canales eficaces incluyen un alias de correo electrónico dedicado, una línea telefónica atendida las 24 horas y la integración en la herramienta de mensajería que los empleados ya utilizan a diario.
Una vez recibida una notificación, alguien debe clasificarla rápidamente. Una matriz de severidad de dos ejes —impacto en el negocio en un eje y confianza en la notificación en el otro— ofrece a los responsables de respuesta un método coherente para hacerlo sin tener que reinventar la lógica cada vez.
- Alto impacto, alta confianza → declarar de inmediato, activar el EGI completo, objetivo de decisión en 30 minutos
- Alto impacto, baja confianza → escalar al responsable técnico para validación rápida, decisión en 2 horas
- Bajo impacto, alta confianza → gestionar a través del proceso operativo estándar, registrar y monitorizar
- Bajo impacto, baja confianza → registrar para análisis de patrones, no se requiere escalada inmediata
La matriz cumple una doble función. Proporciona a los responsables de respuesta un marco de decisión y ofrece a los auditores un registro visible y con marca de tiempo de la rapidez con que la organización pasó de la notificación a la decisión, que es exactamente la métrica que las auditorías de seguimiento suelen examinar.
Consejo práctico: Establezca sus objetivos de tiempo de decisión antes de necesitarlos bajo presión. Una organización que escribe "responder de manera adecuada" en lugar de "declarar en 30 minutos para el Nivel 1" se está dando margen para justificar una respuesta lenta a posteriori, y le está ofreciendo al auditor un hallazgo fácil.
Contención, erradicación, recuperación y comunicación paralela
La respuesta contemplada en el control 5.26 tiene cuatro componentes que ocurren de forma solapada, no en secuencia estricta.
- Contención — aislar los sistemas afectados, limitar el tráfico sospechoso o aplicar restricciones de acceso temporales para detener el daño sin necesidad de corregir la causa de inmediato
- Erradicación — eliminar el malware, cerrar la vulnerabilidad explotada, revocar las credenciales comprometidas y parchear la debilidad subyacente
- Recuperación — restaurar los sistemas desde copias de seguridad limpias, validar la integridad de los datos y volver a poner los servicios en línea en una secuencia controlada
- Comunicación — en ejecución permanente y paralela al trabajo técnico, no añadida como epílogo
El proceso de comunicación es donde las respuestas técnicamente sólidas se tuercen. Las actualizaciones internas deben llegar a la dirección y a los equipos afectados con una cadencia establecida, incluso cuando no hay nada nuevo que comunicar; el silencio se interpreta como pérdida de control. La comunicación externa —a clientes, socios o reguladores— necesita plantillas preaprobadas para que nadie tenga que redactar una notificación de brecha desde cero bajo presión a las 2 de la madrugada.
Consejo práctico: Elabore sus plantillas de notificación a reguladores y clientes con calma, mucho antes de que ocurra un incidente, y obtenga el visto bueno legal sobre el texto estándar con antelación. Editar una plantilla preaprobada bajo la presión de un plazo es una tarea fundamentalmente distinta a redactarla desde una página en blanco mientras las partes interesadas esperan.
La planificación de la reversión pertenece a la fase de erradicación, no como reflexión posterior. Si un parche rompe una dependencia o la revocación de una credencial bloquea una cuenta de servicio legítima, se necesita un camino probado de vuelta al estado conocido como bueno anterior. Para conocer la secuencia específica por sectores, la guía de respuesta a incidentes de Ismscalculator para entornos SGSI bancarios explica cómo las entidades reguladas estructuran este traspaso, y el enfoque se traslada a otros sectores regulados con apenas pequeños ajustes. El diseño de playbooks en general se beneficia de tratar cada tipo de incidente como su propio escenario en lugar de usar una plantilla genérica; la guía operativa de playbooks para respuesta a incidentes defiende un argumento similar a favor de los manuales específicos por escenario frente a un único documento comodín.
Recopilación de evidencias sin ralentizar la respuesta
El control 5.28 pide a las organizaciones que identifiquen, recopilen, adquieran y preserven evidencias de manera que resulten utilizables posteriormente para una investigación o una presentación ante un regulador. Se trata de una disciplina de documentación superpuesta a la respuesta técnica, y es fácil omitirla cuando la prioridad en ese momento es volver a poner los sistemas en línea.
Las evidencias que merece la pena capturar durante casi cualquier incidente incluyen:
- Registros del sistema y de aplicaciones del período afectado, exportados antes de que la rotación los elimine
- Imágenes de memoria o instantáneas forenses de los sistemas en los que se sospecha una brecha activa
- Una cronología de las acciones adoptadas, quién las realizó y cuándo, incluidas las decisiones de contención
- Copias de las comunicaciones internas y externas enviadas durante la respuesta
La cadena de custodia no tiene por qué ser elaborada. Un registro sencillo —quién recopiló la evidencia, cuándo, dónde está almacenada y quién ha accedido a ella desde entonces— satisface a la mayoría de los auditores, y es el tipo de artefacto que la guía de Ismscalculator sobre tipos de evidencias para auditorías de ISO 27001 desarrolla con plantillas concretas.
La tensión real es entre velocidad e integridad. Restaurar un servidor comprometido desde una copia de seguridad puede destruir exactamente el estado de memoria que un investigador forense necesitaría. La solución es una regla sencilla integrada en el playbook con antelación: para cualquier incidente clasificado por encima de un determinado umbral de severidad, hacer una pausa antes de borrar o reconstruir un sistema el tiempo suficiente para capturar una imagen forense. Ese único punto de verificación —decidido con antelación en lugar de negociado en medio del incidente— previene la mayoría de los errores que destruyen evidencias.
Convertir los incidentes en mejoras del SGSI
El control 5.27 es engañosamente sencillo de describir y genuinamente difícil de ejecutar bien: revisar el incidente, encontrar la causa raíz, corregir lo que permitió que ocurriera y demostrar que la corrección se aplicó. Las organizaciones que lo tratan como un mero trámite redactan un resumen de una página y siguen adelante. Las que lo toman en serio lo utilizan para impulsar cambios reales en el SGSI.
Una revisión post-incidente que resiste el escrutinio de una auditoría abarca:
- Lo que ocurrió, en una cronología factual sin interpretaciones editoriales
- La causa raíz, claramente distinguida de los factores contribuyentes
- Las acciones correctivas y preventivas, cada una con un responsable nominado y un plazo
- Qué tratamiento de riesgo o política existente expuso el incidente como inadecuado
El paso que la gente omite es el último. Un informe de incidente que nunca toca el registro de riesgos ni el conjunto de políticas es una narración, no una entrada del SGSI. Los auditores buscan específicamente el vínculo entre "esto ocurrió" y "esto es lo que cambió en nuestros controles documentados como resultado". Sin ese vínculo, incluso un post-mortem bien redactado no aporta nada a su certificación.
¿Qué solicitan los auditores durante las pruebas?
Los organismos de certificación raramente aceptan un archivador de políticas como prueba suficiente de que los controles de gestión de incidentes funcionan. La práctica habitual en las auditorías de seguimiento consiste en repasar un incidente real del ciclo anterior, o realizar un ejercicio de simulación en directo en el acto, para comprobar si el EGI realmente conoce su propio playbook.
Una cadencia de pruebas razonable contempla un ejercicio completo de simulación al año, con un escenario realista como un ransomware o una brecha a través de un tercero, más simulaciones específicas para las áreas de mayor riesgo identificadas en la evaluación de riesgos. Evidencias que conviene conservar de cada ejercicio:
- El escenario escrito y los objetivos
- La asistencia y las asignaciones de funciones de los participantes
- Notas sobre las decisiones tomadas y el tiempo empleado en alcanzarlas
- Una lista de seguimiento de las acciones correctivas que el ejercicio puso de manifiesto, con el estado de seguimiento
Cuando los auditores solicitan muestras, suelen querer un informe de incidente cerrado que muestre el ciclo completo desde la detección hasta las lecciones aprendidas, un registro de cadena de custodia de una recopilación de evidencias real o simulada, y registros de formación que acrediten que los miembros del EGI han ejercitado sus funciones asignadas. Una plantilla práctica de plan de respuesta a incidentes puede ayudar a estructurar estos artefactos si se construye desde cero. La lista de verificación de certificación de Ismscalculator indica dónde encajan estos tipos de evidencias en el proceso más amplio de 80 pasos hacia la certificación.
Algo que ISO deliberadamente no hace: establecer plazos de notificación de brechas. Estos provienen de la jurisdicción en la que opera la organización —leyes estatales de notificación de brechas en EE. UU., HIPAA para datos sanitarios, normas de la SEC para empresas cotizadas—. Los controles de incidentes de ISO rigen el proceso interno, pero el reloj externo corre de forma independiente, y el estándar deja completamente en sus manos la tarea de alinear su cronología de decisiones internas con esos plazos regulatorios.
Cómo ISMS Calculator acelera la preparación para la gestión de incidentes
Construir desde cero los artefactos descritos anteriormente —matriz de severidad, playbooks, plantillas de evidencias— es donde los plazos de implementación se retrasan más, con idas y venidas entre cumplimiento normativo, TI y legal antes de que alguien sepa qué falta realmente. La evaluación de preparación personalizada de Ismscalculator lo abrevia mapeando su documentación actual directamente contra los controles 5.24 al 5.28, y señalando exactamente dónde su matriz de severidad, sus registros de autoridad del EGI o sus plantillas de evidencias son insuficientes.
La evaluación de madurez de Ismscalculator sobre los cuatro temas de control del Annex A puntúa la gestión de incidentes junto al resto de su SGSI, de modo que puede ver si es su dominio más débil o un punto relativamente fuerte. Una vez mapeadas las carencias, las herramientas de Gantt y de planificación temporal de la plataforma le permiten secuenciar el trabajo: primero la matriz de severidad, después la documentación del EGI, a continuación un playbook probado, y las plantillas de evidencias en paralelo.
La comprobación gratuita de preparación tarda unos dos minutos y devuelve una referencia comparativa con organizaciones de tamaño e industria similares —un contexto útil para decidir si su cadencia actual de simulaciones es escasa o está aproximadamente en línea con sus pares—. Los responsables de cumplimiento con poco tiempo suelen utilizarla como primera criba, y luego profundizan en el detalle específico del dominio una vez que saben dónde están las carencias reales.
Perspectiva del autor: la gestión de incidentes como programa iterativo
La trampa de madurez que observo con más frecuencia no es un control que falta. Es una implementación construida íntegramente para la auditoría en lugar de para el incidente. Los equipos redactan una hermosa política del control 5.24, realizan una simulación la semana antes de que llegue el evaluador y luego dejan el playbook sin tocar durante un año. Eso supera la certificación. No sobrevive a un ataque real de ransomware.
Empiece de forma más modesta y más honesta. Construya una matriz de severidad con umbrales reales, nombre un EGI real con autoridad real, y ponga a prueba un playbook hasta que la gente pueda ejecutarlo sin tener el documento abierto delante. Todo lo demás —las plantillas de evidencias, los flujos de trabajo de notificación, el mapeo regulatorio— se vuelve más sencillo una vez que ese ciclo central funciona bajo presión.
Trate cada incidente, real o simulado, como una entrada al SGSI en lugar de un problema que hay que cerrar y olvidar. Esa es la diferencia entre un programa que supera su primera prueba real y uno que solo ha superado su auditoría.
— Martin
Inicie su comprobación de preparación para la gestión de incidentes en ISO 27001
Construir los cinco controles de gestión de incidentes desde cero suele costar semanas de idas y venidas entre cumplimiento normativo, TI y legal antes de que alguien sepa qué falta realmente. La Evaluación de Preparación para ISO 27001 de Ismscalculator abrevia ese proceso mapeando su documentación actual directamente contra los controles 5.24 al 5.28, señalando exactamente dónde su matriz de severidad, sus registros de autoridad del EGI o sus plantillas de evidencias son insuficientes.

La evaluación tarda unos dos minutos en iniciarse y devuelve un informe de carencias personalizado, una comparativa con el modelo de referencia y una estimación del tiempo necesario para cerrar lo que falta. Recibirá un informe en PDF que podrá compartir con la dirección o con un auditor, una lista priorizada de acciones y la opción de guardar sus resultados y compararlos con una estimación futura una vez cerradas las carencias. Si prefiere explorar primero el conjunto completo de herramientas, incluido el planificador de implementación basado en Gantt, la plataforma ISMS Calculator es el punto de partida.
Fuentes
- ISO/IEC 27001:2022 - Sistemas de gestión de la seguridad de la información
- ISO 27001 Incident Management Controls for Response and Records