El NIST define una vulnerabilidad como una debilidad en un sistema de información, en los procedimientos de seguridad del sistema, en los controles internos o en su implementación que podría ser explotada o activada por una fuente de amenaza. Esa definición es importante porque abarca mucho más que código defectuoso. Una regla de firewall mal configurada, una contraseña de administrador predeterminada que no se ha cambiado o un proceso de negocio que omite las revisiones de acceso también cuentan.
Tres aspectos en los que los profesionales deben actuar de inmediato:
- Priorizar utilizando CISA KEV y el contexto de negocio en primer lugar. Las puntuaciones CVSS brutas indican la gravedad técnica; no indican si alguien está explotando activamente la vulnerabilidad en sistemas similares al tuyo. El Catálogo de Vulnerabilidades Explotadas Conocidas de CISA lista las vulnerabilidades observadas como explotadas en entornos reales y es el filtro más potente para las decisiones urgentes de remediación.
- Consultar los catálogos canónicos. El programa CVE asigna identificadores autorizados a las vulnerabilidades divulgadas públicamente, la NVD enriquece esos registros con puntuaciones CVSS y metadatos, y CISA KEV señala cuáles están siendo activamente armadas.
- Vigilar el tiempo de remediación para los activos expuestos públicamente y explotados. Esa única métrica, más que cualquier otro KPI, refleja si tu programa está siguiendo el ritmo de los atacantes en el mundo real.
Tabla de Contenidos
- ¿Qué tipos de vulnerabilidades deben conocer los equipos de seguridad?
- ¿Cómo se descubren, divulgan y asignan CVEs a las vulnerabilidades?
- CVE, CVSS, NVD y CISA KEV: qué hace cada uno y cómo utilizarlos
- El ciclo de vida de la vulnerabilidad y un flujo de trabajo práctico de priorización
- Cómo detectan y evalúan vulnerabilidades los equipos en la práctica
- Estrategias de remediación y cuándo no parchear de inmediato
- KPIs y métricas de gobernanza que demuestran que tu programa funciona
- Cómo se relaciona la gestión de vulnerabilidades con ISO 27001 y tu ISMS
- Conclusiones clave
- La brecha entre las puntuaciones de vulnerabilidad y el riesgo real
- Ismscalculator te ayuda a planificar y presupuestar la remediación de vulnerabilidades para ISO 27001
- Recursos y fuentes autorizadas que todo profesional debe monitorizar
¿Qué tipos de vulnerabilidades deben conocer los equipos de seguridad?
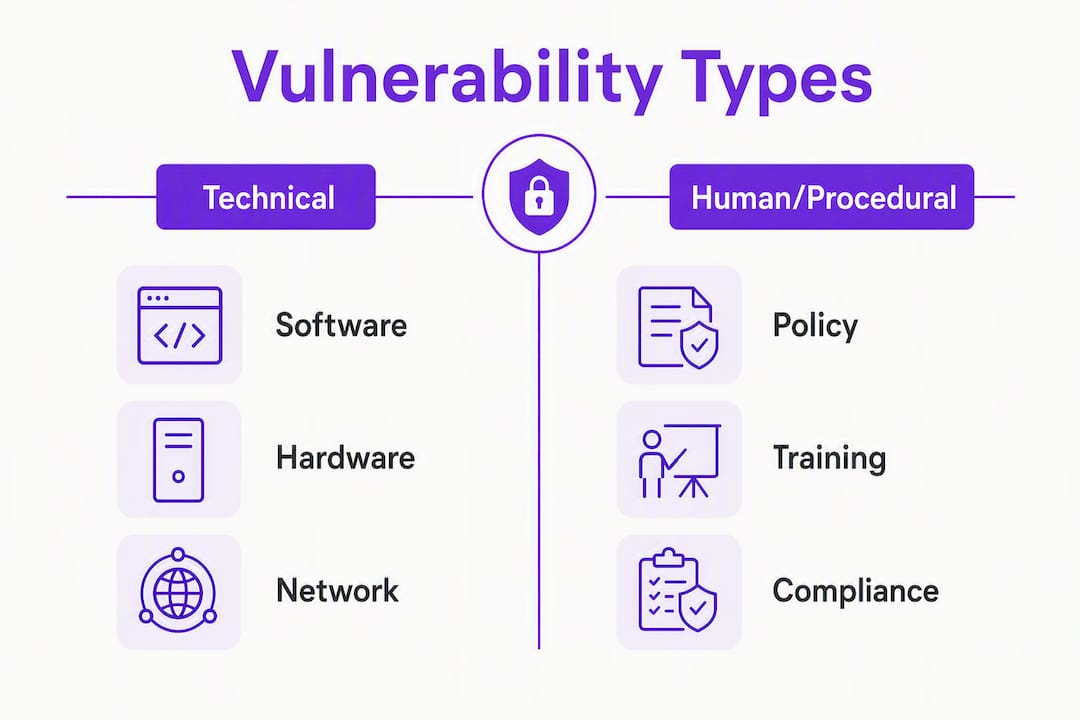
Los equipos de seguridad trabajan con dos grandes categorías: vulnerabilidades técnicas y vulnerabilidades humanas/procedimentales. Esta distinción determina qué métodos de detección aplican y qué remediaciones son viables.
Las vulnerabilidades técnicas residen en software, hardware, firmware, infraestructura de red y configuración. Un fallo de corrupción de memoria en un servidor web, una versión de firmware sin parchear en un switch de red, una política de bucket S3 excesivamente permisiva: todas entran aquí. La detección es en gran medida automatizable: los escáneres, las herramientas de SCA y las comprobaciones de configuración autenticadas pueden detectar la mayoría a escala.
Las vulnerabilidades humanas y procedimentales son más complicadas. La guía del NCSC señala algo importante: una implementación segura puede seguir siendo vulnerable si la configuración predeterminada o las funciones habilitadas crean exposiciones. Un desarrollador que activa el modo de depuración en producción, un equipo de soporte que restablece contraseñas sin verificar la identidad o un proceso de incorporación que concede permisos excesivos por defecto: ninguno de estos casos aparece en un escaneo de puertos.
| Categoría | Ejemplo | Método de detección habitual |
|---|---|---|
| Software (fallos de memoria/lógica) | Log4Shell | SAST, SCA, escáner autenticado |
| Hardware/firmware | BIOS/UEFI sin parchear, fallos de microcódigo de CPU | Avisos de fabricante, escáner de firmware |
| Red/protocolo | RDP expuesto, suites de cifrado TLS débiles | Escáner de red, analizador de protocolos |
| Configuración | Credenciales por defecto, almacenamiento en la nube abierto | Verificaciones CIS Benchmark, herramientas CSPM |
| Humana/procedimental | Proceso débil de restablecimiento de contraseñas, concesión excesiva de accesos | Auditorías de procesos, revisiones de acceso, simulaciones de phishing |
| Cadena de suministro/terceros | Dependencia de código abierto vulnerable | SCA (p. ej., Dependabot, Snyk) |
La tabla anterior es un punto de partida para la clasificación durante el triaje. La categoría determina qué equipo es responsable de la remediación y qué tipo de control cierra la brecha más rápidamente.
¿Cómo se descubren, divulgan y asignan CVEs a las vulnerabilidades?
El camino que va desde "alguien descubre un fallo" hasta "tu escáner lo detecta" involucra a varios actores y puede llevar desde días hasta meses.
Fuentes habituales de descubrimiento:
- Investigadores de seguridad independientes y cazadores de recompensas por errores que notifican a fabricantes o Autoridades de Numeración CVE (CNAs)
- Equipos internos de seguridad de fabricantes y equipos de respuesta a incidentes de seguridad de producto (PSIRTs)
- Proveedores de seguridad y empresas de inteligencia de amenazas que descubren fallos durante la respuesta a incidentes o la investigación de productos
- Equipos de red team internos, auditores de penetración y desarrolladores durante la revisión de código o las pruebas
- Pipelines automatizados de fuzzing y análisis estático que detectan casos límite en CI/CD
El flujo de trabajo estándar de divulgación:
- El investigador identifica un fallo y contacta con el fabricante o una CNA de forma privada.
- El fabricante valida el informe, desarrolla una corrección y coordina un calendario de divulgación (normalmente 90 días según las normas estándar de divulgación responsable).
- Una CNA asigna un identificador CVE, ya sea el propio fabricante, MITRE u otra organización autorizada. El programa CVE cataloga ahora más de 354.000 registros, lo que refleja la escala de las vulnerabilidades divulgadas públicamente.
- El fabricante publica un aviso y un parche simultáneamente con la publicación del CVE, o poco después.
- La NVD ingiere el registro CVE y lo enriquece con puntuaciones CVSS, clasificaciones CWE, identificadores CPE y enlaces de referencia, normalmente en pocos días tras la publicación del CVE, aunque el retraso en el enriquecimiento puede variar.
- Los feeds secundarios (integraciones con SIEM, actualizaciones de firmas de escáneres, CISA KEV) recogen el registro y lo incorporan a los flujos de trabajo de los defensores.
Varias variables comprimen o alargan este calendario. Un zero-day que se está explotando activamente antes de que exista un parche colapsa por completo la ventana de divulgación coordinada. La complejidad del fabricante (una actualización de firmware para hardware embebido tarda más en probarse que un parche de aplicación web) la alarga. Cuando el código de explotación está disponible públicamente antes de que se publique el parche, los defensores se encuentran en una carrera que no eligieron iniciar.
Enfoque práctico de monitorización: Suscríbete a los avisos de CISA y al feed de datos de la NVD mediante API o RSS. Mapea los PSIRTs de los fabricantes de tu pila de software crítico y configura alertas. Incorpora los registros CVE directamente en tu sistema de tickets para que las nuevas divulgaciones creen automáticamente tareas de triaje en lugar de acumularse en la bandeja de entrada de alguien.
CVE, CVSS, NVD y CISA KEV: qué hace cada uno y cómo utilizarlos
Estas cuatro entidades se confunden con frecuencia. Desempeñan funciones distintas y confundirlas lleva a decisiones de priorización erróneas.
CVE es un identificador, nada más. CVE-2023-44487 (HTTP/2 Rapid Reset) te indica de qué fallo se trata, no su gravedad ni si alguien lo está explotando. El programa CVE, gestionado a través de MITRE y una red de CNAs, es el sistema de nomenclatura canónico que utiliza todo el sector para evitar ambigüedades.
CVSS (Sistema Común de Puntuación de Vulnerabilidades), mantenido por FIRST, califica la gravedad técnica en una escala del 0 al 10 en tres grupos de métricas: Base (características técnicas intrínsecas), Temporal (madurez del exploit, disponibilidad de remediación) y Ambiental (tu contexto de despliegue específico). Un CVSS de 9,8 significa que el fallo es técnicamente grave bajo suposiciones de peor caso. No significa que los atacantes lo estén utilizando actualmente contra tu sector.
NVD (Base de Datos Nacional de Vulnerabilidades del NIST) es la capa de enriquecimiento. Toma los registros CVE y añade puntuaciones CVSS, clasificaciones de debilidades CWE, identificadores de producto CPE y enlaces de referencia. La NVD es donde la mayoría de los fabricantes de escáneres y las plataformas SIEM obtienen los metadatos estructurados de vulnerabilidades.
CISA KEV es la señal de priorización. Lista las vulnerabilidades que CISA ha confirmado que están siendo explotadas activamente en entornos reales. La pertenencia al KEV es el indicador más sólido de que una vulnerabilidad necesita atención inmediata, independientemente de la puntuación CVSS.
| Entidad | Qué proporciona | Uso principal en el triaje |
|---|---|---|
| CVE | Identificador único para una vulnerabilidad divulgada | ID de referencia para seguimiento, deduplicación y comunicación |
| CVSS (FIRST) | Puntuación de gravedad técnica (0–10), Base/Temporal/Ambiental | Filtro inicial de gravedad; nunca usar solo para priorizar |
| NVD (NIST) | Metadatos enriquecidos: puntuaciones CVSS, CWE, CPE, referencias | Feed de datos estructurados para escáneres, SIEMs y paneles de control |
| CISA KEV | Explotación activa confirmada en entornos reales | Filtro principal de urgencia; KEV = remediar ahora |
Consejo profesional: No permitas que un CVSS de 9,8 lleve automáticamente una vulnerabilidad al frente de tu cola. Un CVSS de 7,2 que aparece en CISA KEV y afecta a un sistema expuesto públicamente que gestiona tu organización es más urgente. Trata la pertenencia al KEV y la criticidad del activo como los factores principales; usa el CVSS como criterio de desempate secundario.
El ciclo de vida de la vulnerabilidad y un flujo de trabajo práctico de priorización
Una vulnerabilidad no llega ya formada con un plan de remediación adjunto. Pasa por fases, y tu programa necesita una respuesta definida en cada una de ellas.
Fases del ciclo de vida:
- Introducción: el fallo entra en tu entorno (incluido en el código, habilitado por la configuración, introducido a través de un componente de terceros)
- Descubrimiento: detectado internamente (escaneo, pentest, revisión de código) o externamente (publicación de CVE, feed de inteligencia de amenazas)
- Divulgación/emisión de CVE: se crea el registro público; aumenta el conocimiento por parte de los atacantes
- Evaluación: contextualización en tu entorno: ¿qué activos están afectados?, ¿qué controles compensatorios existen?, ¿cuál es el impacto en el negocio?
- Remediación: parchear, mitigar o aceptar con justificación documentada
- Verificación: confirmar que la corrección funcionó; volver a escanear o a probar
- Monitorización: vigilar regresiones, nuevas variantes o CVEs relacionados
La fase de evaluación es donde la mayoría de los programas pierden tiempo. El NIST SP 800-40 enmarca el parcheo como mantenimiento preventivo, no como un ticket de TI ad hoc — un enfoque que obliga a los equipos a presupuestar tiempo para la contextualización en lugar de tratar cada nuevo CVE como una emergencia.
Criterios de priorización (aplicar en este orden):
- Pertenencia al KEV (explotación activa confirmada)
- Disponibilidad pública de código de explotación
- Criticidad del activo e impacto en el negocio
- Exposición de red (cara a Internet frente a interna)
- Controles compensatorios ya existentes
- Complejidad del exploit (local frente a remoto, autenticación requerida)
- Puntuación Base CVSS como criterio de desempate
Flujo de trabajo de triaje en cinco pasos:
- Ingerir el registro CVE; comprobar inmediatamente si pertenece al KEV.
- Mapear los activos afectados en tu inventario; marcar los sistemas expuestos a Internet y los críticos para el negocio.
- Determinar si los controles compensatorios (regla de WAF, segmentación de red) pueden reducir la exposición mientras se prepara el parche.
- Asignar categoría de SLA y responsable; crear un ticket de remediación con seguimiento.
- Tras el parcheo, volver a escanear o probar para verificar el cierre; actualizar el registro de riesgos.
Objetivos de SLA sugeridos:
- Emergencia (KEV + cara a Internet): 48–72 horas
- Alta (CVSS 7,0+ o exploit activo, sistema interno crítico): 7–14 días
- Media (CVSS 4,0–6,9, sin exploit activo): 30–90 días
- Baja (CVSS inferior a 4,0, controles compensatorios presentes): próxima ventana de mantenimiento programada
Al presentar excepciones a la dirección, enmárcalas como riesgo residual con un control compensatorio documentado y una fecha futura de remediación. "No podemos parchear esta semana porque el sistema está en periodo de congelación de mantenimiento; hemos aplicado una regla de WAF y parcheamos el [fecha]" es una postura defendible. El silencio no lo es.
Cómo detectan y evalúan vulnerabilidades los equipos en la práctica
Ninguna herramienta cubre toda la superficie de ataque. Los programas de detección eficaces combinan métodos e integran los resultados en una cola de triaje unificada.
Categorías de detección y sus compromisos:
- Escáneres de red (no autenticados): Rápidos, cobertura amplia; no detectan vulnerabilidades que requieren autenticación. Adecuados para la monitorización de la superficie de ataque externa.
- Escaneo autenticado: Accede a los sistemas para comprobar las versiones de software instaladas y las configuraciones. Mayor fidelidad, mayor carga de gestión de credenciales. Ejecutar semanalmente como mínimo para los activos críticos.
- Análisis de composición de software (SCA): Identifica dependencias de código abierto vulnerables en el código de la aplicación. Herramientas como Dependabot, Snyk o OWASP Dependency-Check se integran directamente en los pipelines de CI/CD para una cobertura continua.
- SAST/DAST: El análisis estático detecta fallos a nivel de código antes del despliegue; el análisis dinámico prueba las aplicaciones en ejecución en busca de inyección, autenticación y fallos lógicos. Ninguno sustituye al otro.
- Fuzzing: Mutación automática de entradas para encontrar fallos y comportamiento inesperado. Especialmente eficaz para parsers, APIs e implementaciones de protocolos. Requiere inversión de ingeniería para su configuración, pero escala bien una vez instrumentado.
- Revisión manual de código y pruebas de penetración: Alta señal, baja frecuencia. Los pentests son episódicos (normalmente anuales o tras cambios importantes); detectan fallos lógicos y rutas de ataque encadenadas que las herramientas automatizadas no encuentran.
- Detección en tiempo de ejecución (EDR/SIEM): Detecta intentos de explotación en curso. No es una herramienta de prevención, pero es esencial para detectar cuándo una vulnerabilidad está siendo activamente atacada en tu entorno.
El desafío práctico es el ruido. Los escáneres autenticados en una red grande producen miles de hallazgos por semana, muchos de ellos falsos positivos o problemas ya mitigados. Reducir ese ruido requiere tres cosas: normalizar los hallazgos de las distintas herramientas en un esquema único, deduplicar por CVE y activo, y correlacionar con el inventario de activos para filtrar los sistemas ya parcheados o aislados.
Consejo profesional: Antes de enviar directamente un hallazgo del escáner a un ticket de remediación, valídalo en un entorno de staging que refleje el de producción. Un hallazgo que genera un falso positivo en staging te ahorra una reversión a medianoche en producción. Correlaciona la salida del escáner con los feeds de inteligencia de amenazas para separar la exposición teórica del ataque activo.
Estrategias de remediación y cuándo no parchear de inmediato
Parchear de inmediato es la respuesta correcta la mayor parte del tiempo. No siempre es operacionalmente seguro, y pretender lo contrario lleva a despliegues ciegos que rompen la producción o a aplazamientos indefinidos sin ningún control compensatorio.
Flujo de decisión:
- Parchear de inmediato cuando existe un parche seguro y probado, el sistema puede tolerar una ventana de mantenimiento y la vulnerabilidad está en el KEV o tiene un CVSS de 9,0+.
- Despliegue escalonado cuando el parche está disponible pero el sistema es crítico para el negocio. Valida en un entorno que no sea producción pero que lo refleje, despliega en un grupo canario reducido, mide la estabilidad y la telemetría, y después procede al despliegue más amplio en producción. Las buenas prácticas de despliegue escalonado exigen tener planes de reversión ensayados antes de cualquier despliegue canario.
- Parcheo virtual cuando aún no existe un parche o el sistema no puede parchearse sin causar una interrupción inaceptable. Una regla de WAF o una firma IPS que bloquea el vector de ataque compra tiempo. El NIST SP 1800-31 documenta el parcheo virtual como un recurso legítimo para sistemas heredados, con una advertencia importante: las correcciones virtuales deben tener políticas de expiración y monitorización para que no se conviertan en deuda técnica permanente y no documentada.
- Segmentación/aislamiento de red cuando el sistema afectado puede trasladarse detrás de un perímetro de red más estricto, reduciendo el radio de impacto aunque la vulnerabilidad permanezca sin parchear.
- Deshabilitación temporal de cuentas o restricción de acceso para vulnerabilidades que requieren acceso autenticado para ser explotadas.
- Aceptación del riesgo con monitorización como último recurso, documentada con un responsable designado, un control compensatorio y una fecha de revisión.
Controles compensatorios con notas de implementación:
- Segmentación de red: Trasladar los sistemas vulnerables a una VLAN restringida; actualizar las ACL del firewall para limitar las conexiones entrantes solo a los puertos requeridos y las IPs de origen.
- Reglas de WAF: Desplegar reglas específicas del fabricante o personalizadas dirigidas al patrón de explotación; probar en modo de solo detección antes del modo de bloqueo.
- Firmas IPS: Habilitar firmas para patrones de explotación conocidos; ajustar para reducir falsos positivos antes del despliegue en producción.
- Aplicación de MFA: Para vulnerabilidades de evasión de autenticación, aplicar MFA en el servicio afectado eleva el listón para la explotación incluso sin un parche.
- Reducción de la exposición de red: Deshabilitar servicios innecesarios, cerrar puertos no utilizados y eliminar el acceso público a sistemas que no lo requieren.
Consejo profesional: Al presentar el coste de remediación a la dirección, enmárcalo frente al coste de una brecha, no solo frente a las horas de ingeniería. Una ventana de parcheo de dos días para una vulnerabilidad del KEV en un sistema de procesamiento de pagos es mucho más barata que la respuesta a incidentes, la notificación regulatoria y el coste reputacional de una explotación. Un informe de remediación de una página con tres campos —vulnerabilidad, riesgo para el negocio si no se parchea, solución propuesta y calendario— obtiene aprobaciones más rápidas que un ticket técnico.
KPIs y métricas de gobernanza que demuestran que tu programa funciona
Las métricas importan porque son la forma en que los responsables de seguridad demuestran el estado del programa a ejecutivos y consejos de administración, y porque revelan dónde falla realmente el programa antes de que lo haga un atacante.
KPIs a monitorizar:
- Tiempo medio de remediación (MTTR): Tiempo medio desde el descubrimiento de la vulnerabilidad hasta el cierre verificado. Monitorizar por separado para hallazgos del KEV y no del KEV; el agregado oculta la cola larga.
- Cobertura de activos: Porcentaje de activos conocidos escaneados en los últimos 30 días. Una cobertura inferior al 90% significa que tienes puntos ciegos.
- Tasa de remediación del KEV dentro del SLA: Porcentaje de vulnerabilidades del CISA KEV que afectan a tu entorno remediadas dentro de tu ventana de SLA de emergencia. Esta es la métrica que reguladores y auditores solicitan cada vez más.
- Distribución de antigüedad del backlog: ¿Qué antigüedad tienen tus hallazgos abiertos? Un alto porcentaje de hallazgos con más de 90 días señala un cuello de botella sistémico en la remediación, no solo un problema de capacidad.
- Tasa de falsos positivos: Las tasas altas de falsos positivos erosionan la confianza de los ingenieros en la salida del escáner y ralentizan el triaje. Monitorizar y ajustar.
- Tasa de éxito de parches: Porcentaje de parches aplicados sin reversión ni incidente. Las tasas bajas indican carencias en las pruebas.
El NIST SP 800-40 enmarca la gestión de vulnerabilidades como mantenimiento preventivo, lo que significa que estas métricas pertenecen a los paneles operativos junto con la disponibilidad y el recuento de incidentes, no enterradas en un informe de seguridad trimestral.
Cadencia de gobernanza:
- Semanal: revisión de remediación para hallazgos del KEV y de nivel de emergencia
- Mensual: revisión del backlog, informe de cumplimiento de SLA, revisión del registro de excepciones
- Trimestral: actualización del panel ejecutivo, análisis de tendencias de KPIs del programa, aprobaciones de excepciones para aplazamientos prolongados
Consejo profesional: Evita reportar el MTTR medio como tu métrica principal. Una media de 14 días parece saludable hasta que te das cuenta de que el 20% de tus hallazgos tienen más de 180 días. Reporta el MTTR como una distribución o en el percentil 90. Ese es el número que muestra si tu programa gestiona los casos difíciles, no solo los fáciles.
Cómo se relaciona la gestión de vulnerabilidades con ISO 27001 y tu ISMS
La gestión de vulnerabilidades no es un programa independiente. Bajo ISO 27001, se mapea directamente a los controles del Annex A y alimenta el plan de tratamiento de riesgos del ISMS. Establecer correctamente ese mapeo es lo que convierte la salida del escáner en evidencia para la auditoría.
| Actividad de vulnerabilidad | Cláusula/control ISO 27001 | Entregable recomendado |
|---|---|---|
| Descubrimiento e inventario de activos | — | Registro de activos mantenido con evidencia de cobertura de escaneo |
| Escaneo autenticado y comprobaciones de configuración | — | Informes de escaneo, registros de línea base de configuración |
| Decisiones de priorización basadas en riesgo | — | Entradas en el registro de riesgos con justificación de priorización documentada |
| Aplicación y verificación de parches | — | Tickets de cambio, resultados de re-escaneo, registros de éxito de parches |
| Controles compensatorios y aceptación del riesgo | — | Registros de aceptación del riesgo con responsable designado y fecha de revisión |
| Monitorización continua y métricas | — | Paneles de KPIs, registros de excepciones, actas de reuniones de gobernanza |
ISO 27001 y la priorización informada por CISA KEV se alinean bien: ambos requieren una priorización documentada y basada en el riesgo en lugar de perseguir puntuaciones CVSS brutas. La implicación práctica es que tus tickets de remediación deben capturar por qué se priorizó o aplazó una vulnerabilidad, no solo el hecho de que se hizo.
Pasos prácticos para la preparación del ISMS en torno a la gestión de vulnerabilidades:
- Mantener un inventario de activos de TI documentado como base para la cobertura de escaneo y la priorización.
- Documentar tu metodología de priorización (KEV + criticidad del activo + controles compensatorios) para que los auditores puedan seguir tu razonamiento.
- Conservar la evidencia de remediación: tickets cerrados, resultados de re-escaneo, instantáneas de configuración y registros de cambios.
- Mapear los controles compensatorios a los controles del Annex A e incluirlos en el plan de tratamiento de riesgos.
- Programar revisiones periódicas por la dirección del backlog de vulnerabilidades como parte de la gobernanza del ISMS.
La presupuestación y planificación de este trabajo es donde la mayoría de los equipos tienen dificultades. Estimar el esfuerzo necesario para cerrar un backlog de 500 elementos en los cuatro temas de control del Annex A, mientras se mantiene el escaneo continuo y la recopilación de evidencias, requiere más que una hoja de cálculo. Una herramienta de planificación que mapee tu madurez en seguridad en los dominios ISO y produzca estimaciones de calendario y coste ofrece a los responsables de cumplimiento y a los gestores de TI algo concreto para llevar a las conversaciones presupuestarias.
Conclusiones clave
Una gestión de vulnerabilidades eficaz trata la evidencia de explotación activa —concretamente, la pertenencia a CISA KEV— como la señal principal de priorización, por delante de las puntuaciones CVSS, para centrar el esfuerzo de remediación donde la actividad atacante está confirmada.
| Punto | Detalles |
|---|---|
| Usa el KEV como filtro principal | La pertenencia a CISA KEV señala explotación activa confirmada; remediar los activos expuestos públicamente del KEV en 48–72 horas. |
| No te bases únicamente en el CVSS | El CVSS mide la gravedad técnica, no la explotación activa; combínalo con la criticidad del activo y el contexto de negocio para una priorización defendible. |
| El parcheo virtual compra tiempo, no permanencia | Los controles compensatorios WAF/IPS son recursos legítimos para sistemas heredados, pero requieren políticas de expiración y monitorización para evitar convertirse en deuda permanente. |
| Monitoriza el MTTR como una distribución | Reportar el MTTR medio oculta los elementos de alto riesgo de la cola larga; usa métricas en el percentil 90 para detectar cuellos de botella sistémicos en la remediación. |
| Ismscalculator para la planificación de ISO 27001 | Ismscalculator mapea las actividades de gestión de vulnerabilidades a las cláusulas de ISO 27001, estima el esfuerzo y el coste, y produce artefactos listos para auditoría en los cuatro temas de controles ISO/IEC 27001:2022 del ISMS. |
La brecha entre las puntuaciones de vulnerabilidad y el riesgo real
La mayoría de las organizaciones con las que veo dificultades en la gestión de vulnerabilidades comparten un problema: han construido su programa en torno a las puntuaciones CVSS porque las puntuaciones son fáciles de reportar. Un panel lleno de 9,8s parece una lista de prioridades clara. El problema es que el CVSS fue diseñado para medir la gravedad técnica bajo suposiciones de peor caso, no para reflejar lo que los atacantes están haciendo realmente en tu sector esta semana.
El cambio que transforma los resultados del programa es tratar la gestión de vulnerabilidades como una disciplina de riesgo continuo en lugar de una cola de parcheo. Eso significa hacer preguntas diferentes: ¿Está este fallo en CISA KEV? ¿Sugiere mi inteligencia de amenazas un ataque activo a este software en mi sector? ¿El sistema afectado está detrás de controles compensatorios que reducen la exposición de forma significativa? Esas preguntas requieren criterio, no solo un umbral de puntuación.
Lo otro que los profesionales subestiman es el lado organizativo. Un marco de priorización técnicamente sólido falla si los ingenieros no confían en la salida del escáner, si la dirección no aprueba ventanas de mantenimiento o si el backlog de remediación no tiene responsable. Enmarcar el parcheo como mantenimiento preventivo, tal como recomienda el NIST SP 800-40, cambia la conversación presupuestaria. El mantenimiento tiene una partida presupuestaria. La respuesta a emergencias no, hasta que la tiene.
Para los equipos que se preparan para ISO 27001, la guía de cumplimiento de gestión de vulnerabilidades merece leerse junto con este artículo. El mapeo entre la actividad operativa diaria y la evidencia para auditoría es donde la mayoría de los programas tienen lagunas, y cerrar esas lagunas antes de una auditoría es mucho menos doloroso que descubrirlas durante ella.
Ismscalculator te ayuda a planificar y presupuestar la remediación de vulnerabilidades para ISO 27001
Saber qué hay que corregir es un problema. Saber cuánto costará, cuánto tardará y qué evidencias pedirán los auditores es un problema completamente distinto.

Ismscalculator es una herramienta de planificación y preparación diseñada para responsables de cumplimiento, gestores de TI y ejecutivos que navegan por la implantación de ISO 27001. No es un escáner ni un proveedor de remediación. Lo que hace es traducir tu madurez en seguridad en los cuatro temas de control del Annex A en una estimación de coste delimitada, un calendario de implementación personalizable y la lista de verificación de artefactos que esperan los auditores. Puedes comparar tu plan con valores de referencia del modelo, guardar y comparar múltiples escenarios y exportar un informe en PDF para llevarlo a una reunión presupuestaria.
Para los equipos que comienzan este proceso, la autoevaluación gratuita de preparación de 2 minutos te proporciona una línea de base inmediata en los dominios de ISO 27001 más relevantes para la gestión de vulnerabilidades. Si necesitas apoyo externo, el directorio de consultores independientes te conecta con implementadores de ISO 27001 y auditores jefe que pueden delimitar el trabajo junto con tu equipo interno.
Recursos y fuentes autorizadas que todo profesional debe monitorizar
Estas son las fuentes principales para datos de vulnerabilidades, orientación sobre puntuación y marcos de cumplimiento. Cada una tiene un método de consumo recomendado para los equipos que construyen pipelines de triaje automatizados.
-
NVD (Base de Datos Nacional de Vulnerabilidades del NIST): La fuente autorizada para registros CVE enriquecidos, incluyendo puntuaciones CVSS, clasificaciones CWE e identificadores CPE. Consumir mediante la API REST de la NVD (feeds JSON) para la ingesta en SIEM o el enriquecimiento de escáneres. Con límite de velocidad; usar una clave de API para integraciones en producción.
-
Catálogo de Vulnerabilidades Explotadas Conocidas de CISA: El filtro principal para la remediación urgente. Disponible como feed JSON actualizado de forma continua. Suscríbete a las alertas de CISA e integra el JSON del KEV en tu sistema de tickets para marcar automáticamente los CVEs del KEV en tu entorno.
-
Programa CVE: El registro de identificadores canónico. Usa los IDs CVE como clave principal para la deduplicación entre herramientas. El feed de datos del programa CVE está disponible en formato JSON y se integra con la mayoría de las plataformas de gestión de vulnerabilidades comerciales y de código abierto.
-
Documentación CVSS de FIRST: FIRST publica la especificación CVSS, la calculadora de puntuación y la orientación para aplicar las métricas Ambientales a tu contexto de despliegue específico. Usa la puntuación Ambiental, no solo la Base, al reportar la gravedad a las partes interesadas.
-
Orientación sobre vulnerabilidades del NIST (CSRC): El Centro de Recursos de Seguridad Informática del NIST publica el SP 800-40 (gestión de parches y vulnerabilidades), el glosario de vulnerabilidades y la orientación sobre marcos. Lectura esencial para la gobernanza del programa y la documentación de políticas.
Nota de integración: Los pipelines de triaje más eficaces ingieren los feeds de la NVD y del KEV mediante API, normalizan los registros CVE contra el inventario de activos y crean tickets automáticamente cuando un nuevo CVE coincide con un activo conocido. Añadir una comprobación de pertenencia al KEV como campo del ticket, con una regla de escalado automático para KEV + activos expuestos a Internet, reduce el tiempo entre la publicación del CVE y la asignación de la remediación de días a minutos.
Recomendado
- Gestión de Vulnerabilidades en el ISMS: Guía de Cumplimiento | ISMS Calculator
- El Rol de las Pruebas de Penetración en el ISMS: Guía de Cumplimiento | ISMS Calculator
- Declaración de Aplicabilidad ISO 27001: Guía Completa | ISMS Calculator
- Evaluación de Riesgos ISO 27001: Guía Completa de Metodología | ISMS Calculator