Beschikbaarheid betekent de eigenschap of toestand van gereed, toegankelijk en bruikbaar zijn wanneer dat nodig is. Merriam-Webster definieert het eenvoudig als "de eigenschap of toestand van beschikbaar zijn", en die definitie geldt of het nu gaat om een vrij tijdslot voor een afspraak of een productiedatabase. In informatiebeveiliging is beschikbaarheid de derde pijler van de CIA-triade, naast vertrouwelijkheid en integriteit. ISO/IEC 27000 en het NIST Cybersecurity Framework behandelen het beide als een formele beveiligingseigenschap: systemen, diensten en gegevens moeten functioneel blijven voor geautoriseerde gebruikers wanneer zij die nodig hebben. Wanneer beschikbaarheid faalt, verliezen organisaties omzet, vertrouwen en soms ook hun positie ten opzichte van toezichthouders.
Belangrijkste Inzichten
Beschikbaarheid betekent dat een systeem, dienst of resource gereed en bruikbaar is wanneer dat nodig is, en organisaties moeten dit zowel als operationele als als beveiligingseigenschap meten, inrichten en beschermen.
| Punt | Details |
|---|---|
| Kerndefinitie | Beschikbaarheid is de eigenschap of toestand van gereed en toegankelijk zijn, en de derde pijler van de CIA-triade in informatiebeveiliging. |
| Meetformule | Beschikbaarheid % = (Totale Tijd − Uitvaltijd) / Totale Tijd × 100; — staat ongeveer 8,76 uur uitvaltijd per jaar toe. |
| Stel doelen op basis van impact | Leid RTO en RPO af uit de kosten van uitvaltijd per uur, niet uit het najagen van opvallende "negens". |
| Belangrijkste beheersmaatregelen | Redundantie, failover, geteste back-ups, monitoring en runbooks zijn de voornaamste technische instrumenten. |
| Aansluiting op standaarden | ISO/IEC 27000 en het NIST Cybersecurity Framework behandelen beschikbaarheid beide als een formele beveiligingsvereiste naast vertrouwelijkheid en integriteit. |
Inhoudsopgave
- Wat betekent beschikbaarheid in het dagelijks taalgebruik?
- Hoe wordt beschikbaarheid gedefinieerd in IT en informatiebeveiliging?
- Hoe wordt beschikbaarheid gemeten?
- Hoe houden organisaties systemen beschikbaar?
- Hoe verschilt beschikbaarheid van disaster recovery?
- Wat zijn de meest voorkomende bedreigingen voor beschikbaarheid?
- Hoe stel je beschikbaarheidsdoelen in op basis van bedrijfsimpact?
- Een praktische beschikbaarheidschecklist voor uw team
- Waarom beschikbaarheidsplanning nu van iedereen is, niet alleen van het operationele team
- Bronnen
Wat betekent beschikbaarheid in het dagelijks taalgebruik?
In de meest basale zin is beschikbaarheid de eigenschap of toestand van gemakkelijk verkrijgbaar, toegankelijk of direct bruikbaar zijn. Het Cambridge Dictionary omschrijft het als "het feit dat iets gekocht, gebruikt of bereikt kan worden, of hoeveel ervan bestaat". Beide definities wijzen op hetzelfde kernidee: iets is beschikbaar wanneer je er nu bij kunt, het kunt gebruiken of het kunt kopen.
Alledaagse voorbeelden maken het concept snel concreet:
- "Ik heb op donderdagmiddag tijd" betekent dat u vrije tijdslots heeft die anderen kunnen boeken.
- "Zolang de voorraad strekt" op een productpagina betekent dat de voorraad op kan zijn voordat uw bestelling is verzonden.
- "De dienst is 24/7 beschikbaar" betekent dat deze continu beschikbaar is zonder geplande sluitingen.
- "Beperkte beschikbaarheid" op een concertticketsite duidt op schaarste, niet op een technische storing.
- "Het medicijn is zonder recept verkrijgbaar" betekent dat er geen recept nodig is om het te verkrijgen.
Merk op dat beschikbaarheid in het gewone taalgebruik vaak vermengd wordt met toegankelijkheid. Dictionary.com stelt dat de twee door elkaar worden gebruikt in zinnen als "De toegankelijkheid van het internet heeft de beschikbaarheid van informatie vergroot." Ze zijn gerelateerd maar niet identiek: toegankelijkheid verwijst vaak naar of iets überhaupt bereikbaar is, terwijl beschikbaarheid ook de dimensies van gereedheid en hoeveelheid omvat.
Pro Tip: Vervang bij het plannen van vergaderingen "laat me weten wanneer u beschikbaar bent" door een specifiek tijdvenster: "Ik ben vrij op dinsdag 10–11 uur of woensdag 14–15 uur." Vage beschikbaarheidsverzoeken leiden tot drie rondes heen-en-weer; een specifiek tijdvenster sluit doorgaans in één keer.
Hoe wordt beschikbaarheid gedefinieerd in IT en informatiebeveiliging?
In IT en beveiliging heeft beschikbaarheid een precieze, door standaarden onderbouwde betekenis. De CIA-triade definieert het als de garantie dat geautoriseerde gebruikers toegang hebben tot systemen en gegevens wanneer dat nodig is, met aanvaardbare prestaties. Het staat naast vertrouwelijkheid (gegevens privé houden) en integriteit (gegevens accuraat houden) als een van de drie fundamentele eigenschappen die elk informatiebeveiligingsprogramma moet beschermen.
ISO/IEC 27000 en het NIST Cybersecurity Framework beschouwen beschikbaarheid beide als een kernbeveiligingsdoelstelling. Het NIST National Cybersecurity Center of Excellence formuleert het als volgt: systemen, informatie, applicaties en diensten moeten toegankelijk en functioneel blijven voor geautoriseerde gebruikers wanneer dat nodig is. Bedreigingen die specifiek gericht zijn op beschikbaarheid omvatten denial-of-service-aanvallen, ransomware, capaciteitsuitputting en uitval van cloudregio's.
Praktische IT-toepassingen waarbij beschikbaarheid de primaire zorg is:
- Een webapplicatie die klanten rond de klok moet bedienen
- Een database die binnen gedefinieerde latentiedrempels op query's moet reageren
- Een API waarvan downstream diensten afhankelijk zijn voor realtime gegevens
- Back-upsystemen die gegevens moeten herstellen binnen een gedefinieerd herstelvenster
- Authenticatiediensten die, wanneer ze niet beschikbaar zijn, alle gebruikers van elk systeem buitensluiten
Dat laatste punt is belangrijker dan de meeste teams beseffen. Beveiligingscontroles kunnen conflicteren met beschikbaarheid: te strikt toegangsbeleid of slecht geïmplementeerde meervoudige authenticatie kan leiden tot uitsluitingen die legitieme gebruikers de toegang ontzeggen. Beschikbaarheid is niet alleen een operationele zorg; het is in beide richtingen een beveiligingszorg.
Hoe wordt beschikbaarheid gemeten?
Beschikbaarheid wordt uitgedrukt als een percentage van de totale tijd dat een systeem operationeel en bruikbaar is. De standaardformule is:
Beschikbaarheid (%) = (Totale Tijd − Uitvaltijd) / Totale Tijd × 100
De "negens"-afkorting
De branche-afkorting "negens" beschrijft hoeveel negens er na de komma staan. Meer negens betekent minder toegestane uitvaltijd per jaar:
| Beschikbaarheid | "Negens" | Max. uitvaltijd per jaar |
|---|---|---|
| — | Twee negens | enkele dagen |
| — | Drie negens | minder dan een halve dag |
| 99.— | Vier negens | minder dan een uur |
| — | Vijf negens | slechts enkele minuten |
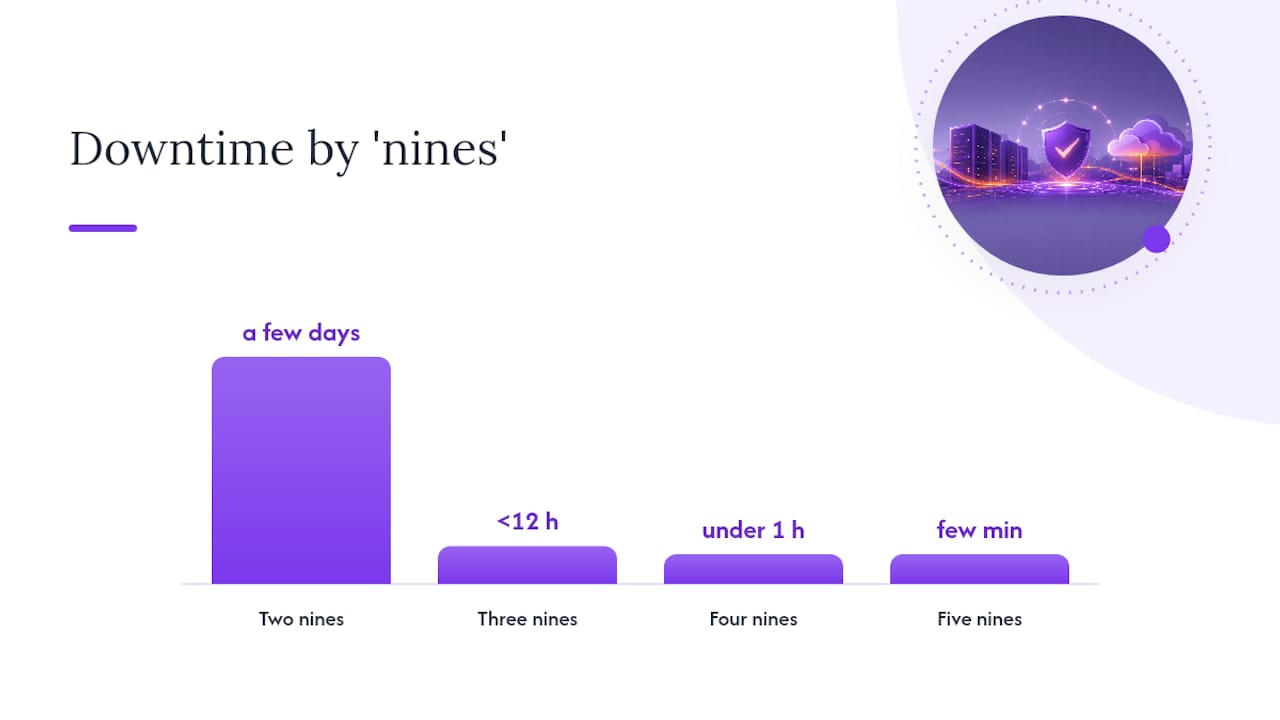
De overgang van drie negens naar vier negens verkleint de toegestane uitvaltijd aanzienlijk. Dat verschil klinkt beheersbaar totdat u het uitdrukt in verloren transacties voor een betalingsverwerker of SLA-boetes voor een managed service provider.
SLA, RTO en RPO
Een SLA (Service Level Agreement) is de contractuele toezegging die het minimaal aanvaardbare beschikbaarheidspercentage definieert, vaak met financiële sancties bij schendingen.
RTO (Recovery Time Objective) is de maximaal aanvaardbare tijd om een systeem te herstellen na een storing. RPO (Recovery Point Objective) is het maximaal aanvaardbare gegevensverlies gemeten in tijd, dat wil zeggen hoe ver u zich kunt veroorloven terug te gaan.
Hun RTO is 4 uur per incident en hun RPO is 1 uur. Dat betekent dat elke storing binnen 4 uur moet zijn verholpen en dat er niet meer dan 1 uur aan gegevens verloren mag gaan. Als zij drie incidenten per jaar ervaren, waarbij elk de volledige 4-uur-RTO verbruikt, is hun jaarlijkse uitvaltijdbudget in drie gebeurtenissen uitgeput.
RTO en RPO zijn niet hetzelfde als beschikbaarheidspercentage. Ze beschrijven hoe snel u herstelt en hoeveel gegevens u verliest, terwijl het beschikbaarheidspercentage beschrijft hoe vaak het systeem beschikbaar is. Alle drie horen thuis in elk serieus beschikbaarheidsgesprek.
Hoe houden organisaties systemen beschikbaar?
Beschikbaarheid ontstaat niet vanzelf. Het vereist bewuste technische keuzes die gelaagd worden toegepast op infrastructuur, architectuur en operaties.
Belangrijkste technische beheersmaatregelen:
- Redundantie: dubbele componenten (servers, voedingen, netwerkpaden) zodat een enkelvoudige storing het systeem niet platleggt
- Taakverdeling (load balancing): verkeer verdelen over meerdere instanties zodat geen enkel knooppunt een knelpunt wordt
- Automatisch schalen (autoscaling): automatisch capaciteit toevoegen wanneer de vraag piekt, om capaciteitsuitputting te voorkomen
- Failover: verkeer automatisch omleiden naar een gezonde instantie wanneer de primaire uitvalt
- Geografische replicatie: gegevens en diensten kopiëren over meerdere regio's of datacenters
- Statuscontroles en monitoring: diensten continu bewaken en waarschuwen bij afwijkingen voordat gebruikers het merken
- Geteste back-ups: back-ups die nooit zijn hersteld zijn geen back-ups; het zijn illusies
Architectuurpatronen vertalen deze beheersmaatregelen naar systeemontwerpen. Een actief-actief-opstelling draait twee of meer identieke instanties tegelijkertijd, verdeelt de belasting en biedt onmiddellijke failover. Een actief-passief-opstelling houdt een stand-byinstantie gereed om over te nemen wanneer de primaire uitvalt, met een korte overschakelvertraging. Graceful degradation stelt een systeem in staat om onder druk niet-kritieke functies af te stoten in plaats van volledig te falen, zodat de kernfunctionaliteit blijft werken.
Pro Tip: Breng vóór de investering in geografische replicatie uw afhankelijkheidsgraph in kaart. Een hoogbeschikbare weblaag die wordt ondersteund door een database in één regio heeft nog steeds een single point of failure. Replicatie op de verkeerde laag verspilt budget zonder de daadwerkelijke beschikbaarheid te verbeteren.
Hoe verschilt beschikbaarheid van disaster recovery?
Deze drie concepten zijn gerelateerd maar lossen verschillende problemen op, en ze door elkaar halen leidt tot verkeerd bestede budgetten.
| Concept | Focus | Aanleiding | Typische middelen |
|---|---|---|---|
| Hoge beschikbaarheid | Uitvaltijd voorkomen tijdens normale operaties | Routinestoringen, verkeerspieken | Redundantie, failover, autoscaling |
| Disaster recovery | Operaties herstellen na een grote gebeurtenis | Catastrofale storing, verlies van datacenter | Back-ups, DR-locatie, runbooks |
| Bedrijfscontinuïteit | Kritieke bedrijfsfuncties draaiende houden | Elke grote verstoring | DR + handmatige noodoplossingen + communicatieplannen |
De AWS Well-Architected Reliability-pijler trekt deze lijn duidelijk: beschikbaarheidstechniek handelt alledaagse verstoringen af; disaster recovery handelt catastrofale verstoringen af. Ze vereisen verschillende investeringen en verschillende testfrequenties.
Gebruik hoge-beschikbaarheidsmaatregelen wanneer:
- Storingen frequent, voorspelbaar of beperkt van omvang zijn (een enkele servercrash, een netwerkunderbrekingen)
- Herstel automatisch en vrijwel onmiddellijk moet verlopen
- De kosten van uitvaltijd per uur hoger zijn dan de kosten van redundante infrastructuur
Schakel over op volledige DR-planning wanneer:
- Een hele regio, datacenter of systeem tegelijkertijd verloren kan gaan
- Herstel menselijk ingrijpen en coördinatie tussen teams vereist
- Wet- en regelgeving geteste herstelprocedures met gedocumenteerde RTO/RPO vereist
Een praktische noot: geplande onderhoudsvensters worden vaak uitgesloten van SLA-beschikbaarheidsberekeningen. Vraag altijd wat het meetvenster omvat en welke uitsluitingen van toepassing zijn voordat u een beschikbaarheidsclaim klakkeloos accepteert.
Wat zijn de meest voorkomende bedreigingen voor beschikbaarheid?
Beschikbaarheidsverlies komt uit twee brede categorieën: opzettelijke aanvallen en onbedoelde storingen. Beide kunnen catastrofaal zijn; ze vereisen alleen andere mitigatiemaatregelen.
Opzettelijke bedreigingen:
- Distributed denial-of-service (DDoS)-aanvallen: een dienst overspoelen met verkeer totdat deze niet meer kan reageren op legitieme verzoeken
- Ransomware: gegevens of systemen versleutelen waardoor ze ontoegankelijk worden totdat losgeld is betaald of back-ups zijn hersteld
- Uitsluitingen via inloggegevens: aanvallers activeren accountvergrendelingsbeleid om legitieme gebruikers de toegang te ontzeggen
Onbedoelde oorzaken:
- Hardwarestoringen: een schijf, voeding of netwerkkaart valt zonder waarschuwing uit
- Softwarefouten: een slechte deployment introduceert een crashlus of geheugenlek
- Capaciteitsuitputting: verkeer groeit sneller dan de infrastructuur schaalt, wat leidt tot time-outs en fouten
- Verlopen certificaten: een TLS-certificaat vervalt en browsers blokkeren de toegang tot de dienst
- Menselijke fouten tijdens onderhoud: een verkeerd geconfigureerde firewallregel, een verwijderde databasetabel of een mislukte deployment-rollback
- Single points of failure: elk onderdeel zonder redundante tegenhanger dat, wanneer het uitvalt, het hele systeem meesleurt
Het belangrijkste onderscheid tussen aanvallen en ongelukken is de intentie, maar de operationele impact is vaak identiek. Een ransomware-aanval en een mislukte databasemigratie kunnen beide leiden tot uren uitvaltijd. Het verschil doet zich voor in de respons: een aanval vereist incidentrespons en forensisch onderzoek; een ongeluk vereist een rollback en een postmortem.
Hoe stel je beschikbaarheidsdoelen in op basis van bedrijfsimpact?
Het najagen van vijf negens omdat een concurrent dat claimt is een veelgemaakte en kostbare fout. De AWS Well-Architected-richtlijnen zijn duidelijk: leid beschikbaarheidsdoelen af uit bedrijfsimpact, niet uit uptimepercentages op marketingniveau.
Een herhaalbare methode:
- Identificeer uw kritieke bedrijfsprocessen. Welke processen stoppen, indien onderbroken, rechtstreeks de omzet, schaden klanten of leiden tot regelgevende sancties?
- Schat de kosten van uitvaltijd per uur. Neem daarin op: gederfde omzet, ondersteuningskosten, SLA-boetes en reputatieschade.
- Vertaal die kosten naar een RTO en RPO. Als één uur uitvaltijd €50.000 kost, moet uw RTO ruim onder één uur liggen. Als het verlies van 24 uur transactiegegevens catastrofaal is, moet uw RPO in minuten worden gemeten.
- Selecteer het infrastructuurpatroon dat aan die doelstellingen voldoet. Pas de architectuur aan op de vereiste, niet andersom.
- Bereken het verschil in kosten. Actief-actief in meerdere regio's kost aanzienlijk meer dan actief-passief in één regio. Als de kosten van de architectuur hoger zijn dan de kosten van de uitvaltijd die het voorkomt, heroverweeg dan het doel.
Drie voorbeelden van hoe dit in de praktijk uitpakt:
- Interne beheerapplicatie: uitvaltijd is ongemakkelijk maar heeft geen omzetimpact. Een RTO van 4 uur en een eenvoudige actief-passief-opstelling met dagelijkse back-ups is proportioneel.
- Publieke e-commercesite: elk uur uitvaltijd kost daadwerkelijke omzet. Een RTO van 15 minuten, een RPO van 5 minuten en een actief-actief-architectuur met realtime replicatie is gerechtvaardigd.
- Gereguleerde financiële dienst: uitvaltijd leidt tot meldingsverplichtingen aan de toezichthouder en mogelijke boetes. RTO gemeten in seconden, RPO vrijwel nul, en geografische redundantie met geteste failover zijn de minimumvereisten.
Pro Tip: Neem gepland onderhoud vanaf dag één op in uw SLA-berekeningen. Onderhandel onderhoudsuitsluitingen expliciet uit, of bouw implementatiepipelines zonder uitvaltijd.
Een praktische beschikbaarheidschecklist voor uw team
De juiste beheersmaatregelen hangen af van uw omvang en risicoprofiel. Begin waar u bent.
Klein team of startup:
- Identificeer de drie diensten zonder welke uw bedrijf niet kan functioneren.
- Bevestig dat elk een geteste back-up en een gedocumenteerde herstelprocedure heeft.
- Stel uptimemonitoring in (ook een gratis tool volstaat) met meldingen naar een telefoon of Slack-kanaal.
- Schrijf voor elke kritieke dienst een eenpagina-runbook: wat te doen als het uitvalt, wie te bellen en waar de back-ups staan.
- Bekijk de SLA van uw hostingprovider en noteer wat is uitgesloten.
Middelgrote organisatie:
- Voer een afhankelijkheidsinventarisatie uit: breng in kaart welke diensten van welke andere afhankelijk zijn en identificeer single points of failure.
- Definieer RTO en RPO voor elk kritiek systeem en verifieer of uw huidige architectuur daaraan kan voldoen.
- Test het herstel van back-ups elk kwartaal, niet alleen het aanmaken van back-ups.
- Implementeer statuscontroles en geautomatiseerde waarschuwingen met escalatiepaden.
- Beoordeel leveranciers-SLA's jaarlijks en stem ze af op uw interne RTO/RPO-doelstellingen.
Enterprise:
- Voer tafeloefeningssimulaties uit die beschikbaarheidsstoringen nabootsen, inclusief ransomwarescenario's.
- Onderhoud een formele business impact analysis (BIA) die processen koppelt aan financiële impact en rechtstreeks invoedt in RTO/RPO-doelstellingen.
- Scheid hoge-beschikbaarheidstechniek van disaster recovery-planning met afzonderlijke eigenaren, budgetten en testschema's.
- Controleer SLA-uitsluitingen bij alle kritieke leveranciers en consolideer rapportage in een centraal beschikbaarheidsdashboard.
- Stem beschikbaarheidsbeheersmaatregelen af op uw ISO 27001-certificering-scope en Verklaring van Toepasselijkheid.
De beste snelle winst voor elk teamformaat: test vandaag uw back-ups. Niet volgend kwartaal. Vandaag. Een back-up die nooit is hersteld is een ongetoetste aanname, en ongetoetste aannames zijn waar beschikbaarheidsplannen falen.
Waarom beschikbaarheidsplanning nu van iedereen is, niet alleen van het operationele team
Het oude denkmodel plaatste beschikbaarheid volledig op het bord van het infrastructuurteam. Operaties hielden de boel draaiende; beveiliging hield de kwaadwillenden buiten; de business stelde de SLA's vast en hoopte het beste. Die scheiding geldt niet meer, en de reden daarvoor is ransomware.
Wanneer een aanvaller uw systemen versleutelt en betaling eist, steelt hij geen gegevens in de traditionele zin. Hij valt de beschikbaarheid aan. De CIA-triade maakt dit expliciet: vertrouwelijkheid, integriteit en beschikbaarheid zijn gelijkwaardige beveiligingseigenschappen. Toch behandelen de meeste organisaties beschikbaarheid nog steeds als een betrouwbaarheidsmetriek en vertrouwelijkheid als de beveiligingsmetriek. Die splitsing laat een kloof open die aanvallers bewust uitbuiten.
De NIST-richtlijnen voor Industry 4.0-cyberbeveiliging maken het integratieargument duidelijk: moderne veerkrachtplanning moet beveiliging, IT-operaties en bedrijfscontinuïteit samenbrengen, omdat bedreigingen geen organisatorische grenzen respecteren. Een ransomware-incident is tegelijkertijd een beveiligingsgebeurtenis, een beschikbaarheidsstoring en een bedrijfscontinuïteitscrisis. Reageren vereist dat alle drie de disciplines vanuit hetzelfde draaiboek werken.
Wat ik consequent onderschat zie worden is hoeveel de business impact analysis alles stroomafwaarts aanstuurt. Teams besteden weken aan de discussie of ze actief-actief of actief-passief moeten bouwen, terwijl de echte vraag is: wat kost één uur uitvaltijd dit bedrijf daadwerkelijk? Beantwoord dat eerlijk en de architectuurbeslissing maakt zich doorgaans vanzelf. De ISO 27001 versus NIST-vergelijking is het lezen waard als u probeert te bepalen welk raamwerk u als basis voor uw beschikbaarheidsbeheersmaatregelen kiest, omdat de twee beschikbaarheid anders behandelen in scope en auditvereisten.
De praktische volgende stap is eenvoudig: kies één kritiek bedrijfsproces, schat wat een uur uitvaltijd kost en vertaal dat naar een RTO. Die ene oefening vertelt u meer over uw werkelijke beschikbaarheidsvereisten dan welke uptimemarketingpagina van een leverancier dan ook.

Als uw organisatie beschikbaarheidsvereisten vertaalt naar een ISO 27001-implementatie, zet Ismscalculator's ISO 27001 Gereedheidsassessment uw beveiligingsbeheersmaatregelen — inclusief beschikbaarheid — om in een op maat gemaakte kosten- en inspanningsschatting. U kunt ook een gratis gereedheidscheck van 2 minuten uitvoeren om te zien waar uw huidige beveiligingspositie staat ten aanzien van alle vier de ISO/IEC 27001:2022-beheersmaatregelthema's, voordat u zich verbindt aan een volledig implementatieplan.