ISO 27001-incidentbeheer rust op vijf Annex A-maatregelen, 5.24 tot en met 5.28, aangevuld met de meldingsverplichting voor personeel in maatregel 6.8. Een conform programma vereist een benoemd Incident Management Team, een gedocumenteerde ernstclassificatiematrix, minimaal één getoetst draaiboek en bewijsregistraties met een verdedigbare chain of custody. Auditors willen geen beleidsverklaringen alleen. Ze willen bewijs dat de cyclus van detectie tot lessons learned daadwerkelijk wordt gesloten.
TL;DR:
- Het implementeren van een gedocumenteerd incident management team met duidelijke bevoegdheden en rolvervanging is essentieel voor effectieve ISO 27001-compliance.
- Organisaties moeten een meetbaar ernstclassificatieproces inrichten om snelle besluitvorming en escalatie binnen vastgestelde tijdlimieten te waarborgen.
- Het verzamelen van bewijsmateriaal, waaronder logbestanden en geheugenopnames, dient vooraf te worden gepland met een chain of custody om gegevensverlies tijdens incidentrespons te voorkomen.
- Regelmatige tabletop-oefeningen en echte incidenten zijn cruciaal om de volledige cyclus van detectie tot lessons learned te toetsen, niet alleen de beleidsdocumentatie.
- Beoordelingstools kunnen snel hiaten in de voorbereiding van incidentbeheer identificeren, zodat u klaar bent voordat een daadwerkelijk incident zich voordoet.
Inhoudsopgave
- Wat omvat ISO 27001-incidentbeheer?
- De vijf incidentbeheermaatregelen, per maatregel toegelicht
- Wie leidt het Incident Management Team?
- Hoe classificeert u de ernst van een incident?
- Containment, eradicatie, herstel en parallelle communicatie
- Bewijsmateriaal verzamelen zonder de respons te vertragen
- Incidenten omzetten in ISMS-verbeteringen
- Wat vragen auditors tijdens toetsing?
- Hoe ISMS Calculator de gereedheid voor incidentbeheer versnelt
- Perspectief van de auteur: incidentbeheer als iteratief programma
- Start uw ISO 27001-gereedheidscheck voor incidentbeheer
- Bronnen
Wat omvat ISO 27001-incidentbeheer?
Informatiebeveiligingskaders maken een scherp onderscheid tussen een "gebeurtenis" en een "incident." Een gebeurtenis is elke waargenomen situatie in een systeem, netwerk of dienst. De meeste gebeurtenissen zijn ruis: een mislukte aanmelding, een geblokkeerde poortscan, een gemarkeerde e-mailbijlage. Een incident is een gebeurtenis (of reeks van gebeurtenissen) die de vertrouwelijkheid, integriteit of beschikbaarheid met reële bedrijfsgevolgen aantast. Dat onderscheid is van belang, omdat het bepaalt op welk moment het incidentbeheerproces wordt geactiveerd.
ISO/IEC 27001:2022 plaatst de incidentbeheervereisten in Annex A, maatregelen 5.24 tot en met 5.28, met een ondersteunende maatregel 6.8 voor personeelsmeldingen. Deze vijf maatregelen staan los van de preventieve maatregelen die het grootste deel van Annex A domineren — toegangsbeveiliging, cryptografie, netwerksegmentatie — omdat zij ervan uitgaan dat er al iets mis is gegaan. Preventieve maatregelen proberen de brand te voorkomen. Incidentbeheermaatregelen bepalen wat u doet zodra er rook in de ruimte hangt.
Dat is een bewuste structurele keuze. Een firewallregelset en een incidentdraaiboek lossen verschillende problemen op: de ene verkleint de kans op een compromittering, de andere regelt wat er gebeurt op het moment dat de kansen tegenvallen. Organisaties die incidentbeheer behandelen als een verlengstuk van hun technische maatregelen, schrijven doorgaans draaiboeken die niemand volgt, omdat de maatregelen lezen als beveiligingsarchitectuur in plaats van een operationeel draaiboek.
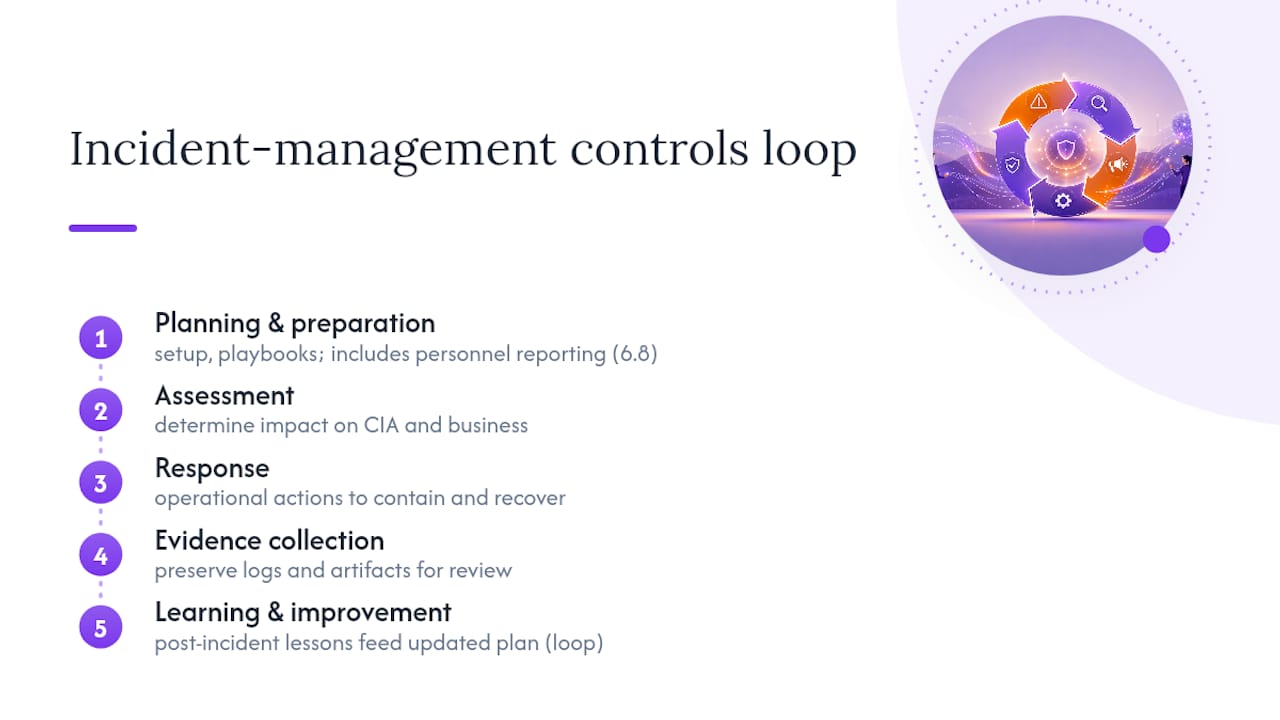
De vijf maatregelen vormen een cyclus, geen checklist. Planning en voorbereiding voeden beoordeling, beoordeling voedt respons, respons voedt bewijsverzameling, en bewijsverzameling voedt leren — dat op zijn beurt het plan bijwerkt. Praktijkrichtlijnen over de incidentbeheer-maatregelenset beschrijven deze cyclus als wat auditors daadwerkelijk toetsen — vaak door een echt incident of een tabletop-oefening door te lopen in plaats van documenten afzonderlijk te lezen. Een map vol beleidsformuleringen zonder enig bewijs dat de cyclus ooit heeft gedraaid, is de meest voorkomende bevinding bij surveillance-audits.
De vijf incidentbeheermaatregelen, per maatregel toegelicht
Elke maatregel correspondeert met een afzonderlijke fase van de incidentlevenscyclus en produceert een specifiek bewijsstuk dat een auditor zal opvragen. Het ontbreken van dat bewijsstuk — ook wanneer de onderliggende activiteit heeft plaatsgevonden — staat functioneel gelijk aan het niet uitvoeren van de maatregel.
5.24, Planning en voorbereiding van incidentbeheer. Deze maatregel vereist een gedocumenteerd beleid dat definieert wat als incident wordt beschouwd, wie de bevoegdheid heeft een incident te verklaren en hoe de organisatie zal reageren. Dit is de basis waarop alles verder wordt gebouwd.
- Een benoemd Incident Management Team (IMT) met gedefinieerde rollen
- Schriftelijke draaiboeken voor veelvoorkomende scenario's (ransomware, gegevenslekken, denial of service, misbruik door insiders)
- Communicatiekanalen en escalatiepaden, inclusief contactgegevens buiten kantooruren
- Vooraf goedgekeurde sjablonen voor interne updates, meldingen aan toezichthouders en klantcommunicatie
5.25, Beoordeling en besluitvorming. Zodra iets is gemeld, moet iemand snel beslissen of het een daadwerkelijk incident betreft en hoe ernstig het is. Deze maatregel vraagt om een herhaalbare classificatiemethode — geen oordeel dat elke keer opnieuw van de grond af wordt opgebouwd.
- Leg de aanleiding vast met tijdstempel en bron
- Pas een ernstclassificatie toe (hieronder in detail besproken)
- Besluit of het incident formeel wordt verklaard
- Registreer het besluit en de tijd die nodig was om het te bereiken
5.26, Respons. Dit is de operationele kern: het probleem indammen, de oorzaak verwijderen, de normale dienstverlening herstellen en belanghebbenden gedurende het gehele proces op de hoogte houden. Auditors verwachten te zien dat containment-stappen niet wachtten op een volledige root-cause-analyse. Snelheid is in de eerste uren belangrijker dan volledigheid.
5.27, Leren van incidenten. Elk afgesloten incident dient een beknopte evaluatie op te leveren: wat er is gebeurd, waarom, en wat er zal veranderen. Dit is de maatregel waarbij een programma ofwel aantoonbaar volwassener wordt, ofwel stagneert. Organisaties die deze stap overslaan, belanden uiteindelijk in hetzelfde incident — soms met dezelfde grondoorzaak — een jaar later.
5.28, Verzameling van bewijsmateriaal. Logbestanden, schermafbeeldingen, geheugenopnames en communicatieregistraties hebben een gedocumenteerde chain of custody nodig vanaf het moment dat ze worden verzameld. Dit is van belang zelfs wanneer juridische procedures op het moment van het incident onwaarschijnlijk lijken, omdat die aanname achteraf regelmatig onjuist blijkt te zijn.
De clausuletekst in de editie van 2022 schrijft bewust geen exacte tools of formaten voor. Die flexibiliteit is een voordeel voor organisaties die al een volwassen IT-servicemanagement voeren, en een valkuil voor organisaties die "flexibel" interpreteren als "optioneel." De Annex A-maatregelengids van Ismscalculator beschrijft hoe deze vijf maatregelen zich verhouden tot de rest van Annex A, als u de bredere context nodig heeft.
Wie leidt het Incident Management Team?
Een IMT dat alleen op een organogram bestaat, is erger dan geen IMT, omdat het auditors een document geeft om gaten in te prikken. Het team heeft benoemde personen, gedefinieerde bevoegdheden en een gedocumenteerd overdrachtsproces nodig voor wanneer de primaire contactpersoon niet bereikbaar is.
Een functionerend IMT omvat doorgaans:
- Incidentcommandant — verantwoordelijk voor het besluit om een incident te verklaren, te escaleren of te sluiten, en coördineert elke andere rol tijdens de actieve respons
- Technisch lead — stuurt de containment- en eradicatiewerkzaamheden over systemen aan en trekt waar nodig gespecialiseerde engineers bij
- Communicatieverantwoordelijke — stelt interne updates, klantberichten en persverklaringen op en laat deze goedkeuren voordat ze worden verzonden
- Juridische vertegenwoordiger of compliance-verantwoordelijke — beslist wanneer externe juridisch adviseurs of forensische specialisten worden ingeschakeld en bewaakt verplichtingen tot melding aan toezichthouders
- HR- of personeelsvertegenwoordiger — behandelt gevallen met betrekking tot insider threats, wangedrag van medewerkers of disciplinaire opvolging
Bevoegdheden zijn het onderdeel dat organisaties het meest onderdocumenteren. Kan de technisch lead een productieserver isoleren zonder eerst een change-managementticket aan te maken? Kan de incidentcommandant een klantmelding autoriseren voordat de juridische afdeling aftekent, als snelheid zwaarder weegt dan perfectie? Deze antwoorden moeten in het plan zelf staan — niet in iemands geheugen van "hoe we dat gewoonlijk regelen."
Documenteer de delegatie van bevoegdheden op dezelfde manier als elke andere maatregel: naam van de persoon, reikwijdte van de bevoegdheid, ingangsdatum en een handtekening of systeemregistratie waaruit de erkenning blijkt. Combineer dat met trainingsregistraties waaruit blijkt dat elk IMT-lid minimaal één tabletop-oefening in zijn of haar rol heeft doorlopen. Auditors vragen naar beide, en een team met bevoegdheden maar zonder trainingsbewijzen oogt bijna even onvoorbereid als een team zonder beide.
Hoe classificeert u de ernst van een incident?
Maatregel 6.8 verplicht organisaties om medewerkers een duidelijke, laagdrempelige manier te bieden om vermoede beveiligingsgebeurtenissen te melden. Als melden drie goedkeuringen vereist en een ticket in een systeem waarvoor niemand de inloggegevens meer weet, zullen mensen niet melden — en de volledige incidentbeheercyclus droogt aan de bron op. Effectieve kanalen zijn onder meer een speciaal e-mailalias, een telefonische hotline die 24/7 bereikbaar is, en integratie in de chat-applicatie die medewerkers dagelijks al gebruiken.
Zodra een melding binnenkomt, moet iemand snel triage uitvoeren. Een tweedimensionale ernstmatrix — bedrijfsimpact op de ene as, betrouwbaarheid van de melding op de andere — biedt respondenten een consistente manier om dat te doen zonder de logica elke keer opnieuw uit te vinden.
- Hoge impact, hoge betrouwbaarheid → direct verklaren, volledig IMT activeren, beslissing binnen 30 minuten als doelstelling
- Hoge impact, lage betrouwbaarheid → escaleren naar technisch lead voor snelle validatie, beslissing binnen 2 uur
- Lage impact, hoge betrouwbaarheid → afhandelen via standaard operationeel proces, vastleggen en monitoren
- Lage impact, lage betrouwbaarheid → vastleggen voor patroonanalyse, geen directe escalatie vereist
De matrix vervult een dubbele functie. Ze biedt respondenten een beslissingsraamwerk, en ze geeft auditors een zichtbare, van tijdstempels voorziene registratie van hoe snel de organisatie van melding naar beslissing is gegaan — precies de metric die surveillance-audits graag onder de loep nemen.
Pro tip: Stel uw beslissingstermijnen van tevoren vast, ruim voordat u ze onder druk nodig heeft. Een organisatie die "reageer adequaat" schrijft in plaats van "verklaar binnen 30 minuten voor Tier 1-incidenten," geeft zichzelf ruimte om een trage respons achteraf goed te praten — en geeft een auditor een gemakkelijke bevinding.
Containment, eradicatie, herstel en parallelle communicatie
Respons onder maatregel 5.26 heeft vier onderdelen die op overlappende tijdstippen plaatsvinden — niet in strikte volgorde.
- Containment — getroffen systemen isoleren, verdacht verkeer beperken of tijdelijke toegangsbeperkingen toepassen om verdere schade te stoppen, zonder noodzakelijkerwijs de oorzaak al te verhelpen
- Eradicatie — malware verwijderen, de uitgebuite kwetsbaarheid dichten, gecompromitteerde inloggegevens intrekken en de onderliggende zwakheid patchen
- Herstel — systemen terugzetten vanuit schone back-ups, de gegevensintegriteit valideren en diensten in een beheerste volgorde weer online brengen
- Communicatie — loopt gedurende de gehele respons parallel aan het technische werk, niet er achteraan geplakt
Het communicatiespoor is waar technisch solide respons ontspoort. Interne updates moeten met een vaste regelmaat leiding en betrokken teams bereiken — ook wanneer er niets nieuws te melden is, want stilte wordt ervaren als controleverlies. Externe communicatie — naar klanten, partners of toezichthouders — vereist vooraf goedgekeurde sjablonen, zodat niemand onder druk om 2 uur 's nachts van een leeg vel papier een melding van een datalek hoeft te schrijven.
Pro tip: Stel uw sjablonen voor meldingen aan toezichthouders en klanten op in rustige tijden, ruim vóór een incident, en laat de standaardtekst vooraf juridisch aftekenen. Een vooraf goedgekeurd sjabloon aanpassen onder tijdsdruk is een fundamenteel andere taak dan er een schrijven vanuit een leeg document terwijl belanghebbenden wachten.
Terugrolplanning hoort thuis in de eradicatiefase — niet als nagedachte. Als een patch een afhankelijkheid verbreekt of het intrekken van inloggegevens een legitiem serviceaccount uitsluit, heeft u een getoetst terugvalpad naar de vorige bekende goede toestand nodig. Voor sectorspecifieke volgorde beschrijft de incidentresponsegids van Ismscalculator voor bancaire ISMS-omgevingen hoe gereguleerde instellingen deze overdracht structureren — en het raamwerk is met slechts kleine aanpassingen toepasbaar op andere gereguleerde sectoren. Draaiboekontwerp profiteert over het algemeen van het behandelen van elk incidenttype als een eigen scenario in plaats van één generiek sjabloon; operationele draaiboekrichtlijnen voor incidentrespons bepleiten eveneens scenariospecifieke draaiboeken boven één allesomvattend document.
Bewijsmateriaal verzamelen zonder de respons te vertragen
Maatregel 5.28 vraagt organisaties om bewijsmateriaal te identificeren, verzamelen, verkrijgen en bewaren op een manier die het bruikbaar houdt voor later onderzoek of indiening bij toezichthouders. Dat is een documentatiediscipline bovenop de technische respons, en het wordt gemakkelijk overgeslagen wanneer de prioriteit op dat moment is systemen weer online te krijgen.
Bewijsmateriaal dat bij vrijwel elk incident het verzamelen waard is:
- Systeem- en applicatielogboeken uit de betreffende periode, geëxporteerd voordat rotatie ze verwijdert
- Geheugenimages of forensische snapshots van systemen waarvan actieve compromittering wordt vermoed
- Een tijdlijn van uitgevoerde acties — door wie en wanneer — inclusief containment-beslissingen
- Kopieën van interne en externe communicatie verstuurd tijdens de respons
Chain of custody hoeft niet ingewikkeld te zijn. Een eenvoudig logboek — wie het bewijsmateriaal heeft verzameld, wanneer, waar het is opgeslagen en wie er sindsdien toegang toe heeft gehad — voldoet voor de meeste auditors, en het is het type bewijsstuk dat de Ismscalculator-gids over bewijstypes voor ISO 27001-audits behandelt met concrete sjablonen.
De werkelijke spanning is die tussen snelheid en integriteit. Het terugzetten van een gecompromitteerde server vanuit een back-up kan precies de geheugentoestand vernietigen die een forensisch onderzoeker zou willen. De oplossing is een eenvoudige regel die vooraf in het draaiboek is opgenomen: pauzeer voor elk incident dat boven een vastgestelde ernstgrens is geclassificeerd, voordat u een systeem wist of herbouwt, lang genoeg om een forensisch image vast te leggen. Dat ene controlepunt — vooraf vastgesteld in plaats van midden in een incident onderhandeld — voorkomt de meeste bewijsvernietigende fouten.
Incidenten omzetten in ISMS-verbeteringen
Maatregel 5.27 is bedrieglijk eenvoudig te beschrijven en oprecht moeilijk goed uit te voeren: evalueer het incident, stel de grondoorzaak vast, verhelp wat het heeft laten ontstaan, en bewijs dat de maatregel effect heeft gehad. Organisaties die dit als formaliteit behandelen, schrijven een eenpagina-samenvatting en gaan verder. Organisaties die het serieus nemen, gebruiken het om echte ISMS-verandering te bewerkstelligen.
Een post-incident-evaluatie die stand houdt bij auditscrutinie, dekt:
- Wat er is gebeurd, in een feitelijke tijdlijn zonder waardeoordelen
- De grondoorzaak, duidelijk onderscheiden van bijdragende factoren
- Corrigerende en preventieve maatregelen, elk met een benoemde eigenaar en een deadline
- Welke bestaande risicobehandeling of welk beleid het incident als ontoereikend heeft blootgelegd
De stap die mensen overslaan, is de laatste. Een incidentrapport dat het risicoregister of de beleidsset nooit raakt, is een verhaal — geen ISMS-input. Auditors kijken specifiek naar de koppeling tussen "dit is gebeurd" en "dit is veranderd in onze gedocumenteerde maatregelen als gevolg daarvan." Zonder die koppeling draagt zelfs een goed geschreven post-mortem niets bij aan uw certificering.
Wat vragen auditors tijdens toetsing?
Certificerende instellingen accepteren zelden een beleidsmap als voldoende bewijs dat de incidentbeheermaatregelen werken. In surveillance-audits is het gebruikelijk een echt incident uit de afgelopen cyclus door te lopen, of ter plekke een live tabletop-oefening uit te voeren, om te zien of het IMT zijn eigen draaiboek daadwerkelijk kent.
Een redelijke toetsingscadans ziet er als volgt uit: één volledige tabletop-oefening per jaar, gericht op een realistisch scenario zoals ransomware of een datalek bij een derde partij, aangevuld met gerichte simulaties voor hogerrisicogebieden die in de risicobeoordeling zijn geïdentificeerd. Bewijsstukken om te bewaren van elke oefening:
- Het schriftelijke scenario en de doelstellingen
- Aanwezigheidslijst en rolverdelingen van deelnemers
- Aantekeningen over genomen beslissingen en de tijd die nodig was om ze te bereiken
- Een bijgehouden lijst van corrigerende maatregelen die de oefening aan het licht bracht, met de opvolgingsstatus
Wanneer auditors steekproeven opvragen, willen ze doorgaans een afgesloten incidentrapport dat de volledige cyclus van detectie tot lessons learned toont, een chain-of-custody-registratie van een daadwerkelijke of gesimuleerde bewijsverzameling, en trainingsregistraties die aantonen dat IMT-leden hun toegewezen rollen hebben geoefend. Een praktisch sjabloon voor een incidentresponsplan kan helpen deze bewijsstukken te structureren als u van nul begint. De certificeringschecklist van Ismscalculator beschrijft waar deze bewijstypes passen binnen het bredere 80-stappen pad naar certificering.
Één ding doet ISO bewust niet: deadlines voor externe meldingen vastleggen. Die komen van de jurisdicties waar de organisatie actief is — meldplichten bij datalekken per Amerikaanse staat, HIPAA voor gezondheidsgegevens, SEC-regels voor beursgenoteerde bedrijven. De ISO-incidentmaatregelen regelen het interne proces, maar de externe klok loopt onafhankelijk — en het in kaart brengen van uw interne beslissingstijdlijn ten opzichte van die wettelijke deadlines is een taak die de norm volledig aan uzelf overlaat.
Hoe ISMS Calculator de gereedheid voor incidentbeheer versnelt
Het vanaf nul opbouwen van de bovenstaande bewijsstukken — ernstmatrix, draaiboeken, bewijssjablonen — is waar de meeste implementatietijdlijnen vertraging oplopen door het heen-en-weerverkeer tussen compliance, IT en juridische zaken, voordat iemand weet wat er daadwerkelijk ontbreekt. Een op maat gemaakte gereedheidsbeoordelingen identificeert precies welke van de maatregelen 5.24 tot en met 5.28 al werkende documentatie hebben en welke slechts plaatsaanduidingstekst bevatten — voordat een auditor de lacune voor u ontdekt.
De volwassenheidsbeoordelingstool van Ismscalculator over de vier Annex A-maatregelthema's scoort incidentbeheer naast de rest van uw ISMS, zodat u ziet of het uw zwakste domein is of een relatieve sterkte. Zodra de lacunes in kaart zijn gebracht, kunt u met de Gantt- en tijdlijntools van het platform de werkzaamheden sequentiëren: ernstmatrix als eerste, IMT-documentatie als tweede, een getoetst draaiboek als derde, bewijssjablonen parallel daaraan.
De gratis gereedheidscheck duurt ongeveer twee minuten en levert een vergelijking op met organisaties van vergelijkbare omvang en branche — nuttige context wanneer u besluit of uw huidige tabletop-cadans aan de magere kant is of ruwweg in lijn met peers. Compliance-verantwoordelijken met weinig tijd gebruiken het doorgaans als eerste screening, waarna ze de domeinspecifieke details induiken zodra ze weten waar de echte lacunes zitten.
Perspectief van de auteur: incidentbeheer als iteratief programma
De meest voorkomende volwassenheidsval die ik zie, is geen ontbrekende maatregel. Het is een implementatie die volledig is gebouwd voor de audit in plaats van voor het incident. Teams schrijven een prachtig 5.24-beleid, draaien één tabletop-oefening de week voor de auditor arriveert, en laten het draaiboek vervolgens een jaar onaangeroerd liggen. Dat slaagt voor de certificering. Het overleeft een echt ransomware-incident niet.
Begin kleiner en eerlijker dan dat. Bouw een ernstmatrix met echte drempelwaarden, benoem een echt IMT met echte bevoegdheden, en test één draaiboek totdat mensen het kunnen uitvoeren zonder het document voor zich te hoeven hebben. Al het andere — de bewijssjablonen, de meldingsworkflows, de regulatoire mapping — wordt makkelijker zodra die kern onder druk werkt.
Behandel elk incident — echt of gesimuleerd — als input voor het ISMS in plaats van als een probleem om te sluiten en te vergeten. Dat is het verschil tussen een programma dat zijn eerste echte test doorstaat en een programma dat alleen zijn audit heeft doorstaan.
— Martin
Start uw ISO 27001-gereedheidscheck voor incidentbeheer
Het vanaf nul opbouwen van de vijf incidentbeheermaatregelen kost doorgaans weken van afstemming tussen compliance, IT en juridische zaken voordat iemand weet wat er daadwerkelijk ontbreekt. De ISO 27001 Readiness Assessment van Ismscalculator verkort dat traject door uw huidige documentatie direct te mappen op maatregelen 5.24 tot en met 5.28 en precies aan te geven waar uw ernstmatrix, IMT-bevoegdheidsregistraties of bewijssjablonen tekortschieten.

De beoordeling duurt ongeveer twee minuten om te starten en levert een op maat gemaakt lacunerapport op, een vergelijking met het referentiemodel en een tijdschatting voor het dichten van de geconstateerde lacunes. U krijgt een pdf-rapport dat u kunt delen met leiding of een auditor, een geprioriteerde actielijst en de mogelijkheid uw resultaten op te slaan en ze te vergelijken met een toekomstige schatting nadat u lacunes heeft gedicht. Als u liever eerst de volledige toolkit verkent — inclusief de Gantt-gebaseerde implementatieplanner — is het ISMS Calculator-platform het startpunt.
Bronnen
- ISO/IEC 27001:2022 - Informatiebeveiligingsbeheersystemen
- ISO 27001 Incident Management Controls for Response and Records