Verfügbarkeit bezeichnet die Eigenschaft oder den Zustand, bei Bedarf bereit, zugänglich und nutzbar zu sein. Merriam-Webster definiert sie schlicht als „die Eigenschaft oder den Zustand, verfügbar zu sein" – und diese Definition gilt gleichermaßen für einen freien Terminslot wie für eine Produktionsdatenbank. In der Informationssicherheit ist Verfügbarkeit die dritte Säule der CIA-Triade, neben Vertraulichkeit und Integrität. Sowohl ISO/IEC 27000 als auch das NIST Cybersecurity Framework behandeln sie als formale Sicherheitseigenschaft: Systeme, Dienste und Daten müssen für autorisierte Nutzer funktionsfähig bleiben, wenn diese sie benötigen. Wenn Verfügbarkeit nicht gewährleistet ist, verlieren Organisationen Umsatz, Vertrauen und mitunter ihren regulatorischen Status.
Wesentliche Erkenntnisse
Verfügbarkeit bedeutet, dass ein System, ein Dienst oder eine Ressource bei Bedarf bereit und nutzbar ist. Organisationen müssen sie sowohl als betriebliche als auch als sicherheitsrelevante Eigenschaft messen, technisch absichern und schützen.
| Punkt | Details |
|---|---|
| Kerndefinition | Verfügbarkeit ist die Eigenschaft oder der Zustand, bereit und zugänglich zu sein, und die dritte Säule der CIA-Triade in der Informationssicherheit. |
| Berechnungsformel | Verfügbarkeit % = (Gesamtzeit − Ausfallzeit) / Gesamtzeit × 100; — erlaubt etwa 8,76 Stunden Ausfallzeit pro Jahr. |
| Ziele aus dem Impact ableiten | RTO und RPO aus den Kosten der Ausfallzeit pro Stunde ableiten, nicht aus der Jagd nach marktüblichen „Neunen". |
| Wesentliche Maßnahmen | Redundanz, Failover, getestete Backups, Monitoring und Runbooks sind die zentralen technischen Stellhebel. |
| Normausrichtung | ISO/IEC 27000 und das NIST Cybersecurity Framework behandeln Verfügbarkeit als formale Sicherheitsanforderung neben Vertraulichkeit und Integrität. |
Inhaltsverzeichnis
- Was bedeutet Verfügbarkeit im alltäglichen Sprachgebrauch?
- Wie wird Verfügbarkeit in IT und Informationssicherheit definiert?
- Wie wird Verfügbarkeit gemessen?
- Wie halten Organisationen Systeme verfügbar?
- Wie unterscheidet sich Verfügbarkeit von Disaster Recovery?
- Was sind die häufigsten Bedrohungen für die Verfügbarkeit?
- Wie sollten Verfügbarkeitsziele aus dem Business Impact abgeleitet werden?
- Eine praktische Verfügbarkeits-Checkliste für Ihr Team
- Warum Verfügbarkeitsplanung heute alle angeht – nicht nur das Operations-Team
- Quellen
Was bedeutet Verfügbarkeit im alltäglichen Sprachgebrauch?
Im Grundsatz ist Verfügbarkeit die Eigenschaft oder der Zustand, leicht erhältlich, zugänglich oder sofort nutzbar zu sein. Das Cambridge Dictionary fasst es so: „die Tatsache, dass etwas gekauft, genutzt oder erreicht werden kann, oder wie viel davon vorhanden ist." Beide Definitionen verweisen auf denselben Kerngedanken: Etwas ist verfügbar, wenn man jetzt darauf zugreifen, es nutzen oder kaufen kann.
Alltägliche Beispiele machen das Konzept schnell greifbar:
- „Ich habe am Donnerstagnachmittag Zeit" bedeutet, dass offene Terminslots vorhanden sind, die andere buchen können.
- „Solange der Vorrat reicht" auf einer Produktseite bedeutet, dass der Lagerbestand vor dem Versand aufgebraucht sein kann.
- „Der Dienst ist 24/7 verfügbar" bedeutet, dass er ohne geplante Schließzeiten durchgehend in Betrieb ist.
- „Begrenzte Verfügbarkeit" auf einer Konzertticketseite signalisiert Knappheit, keinen technischen Fehler.
- „Das Medikament ist rezeptfrei erhältlich" bedeutet, dass kein Rezept für den Kauf erforderlich ist.
Im allgemeinen Sprachgebrauch vermischt sich Verfügbarkeit häufig mit Zugänglichkeit. Dictionary.com weist darauf hin, dass beide Begriffe in Sätzen wie „Die Zugänglichkeit des Internets hat die Verfügbarkeit von Informationen erhöht" synonym verwendet werden. Sie sind verwandt, aber nicht identisch: Zugänglichkeit bezieht sich oft darauf, ob etwas überhaupt erreichbar ist, während Verfügbarkeit zusätzlich die Dimension der Bereitschaft und Menge umfasst.
Praxistipp: Ersetzen Sie bei der Terminplanung „Schicken Sie mir bitte Ihre Verfügbarkeiten" durch ein konkretes Zeitfenster: „Ich bin dienstags von 10–11 Uhr oder mittwochs von 14–15 Uhr frei." Vage Anfragen nach Verfügbarkeiten erzeugen drei Abstimmungsrunden; ein konkretes Zeitfenster schließt die Sache meist in einer ab.
Wie wird Verfügbarkeit in IT und Informationssicherheit definiert?
In IT und Sicherheit hat Verfügbarkeit eine präzise, normgestützte Bedeutung. Die CIA-Triade definiert sie als die Garantie, dass autorisierte Nutzer bei Bedarf mit akzeptabler Performance auf Systeme und Daten zugreifen können. Sie steht neben Vertraulichkeit (Datenschutz) und Integrität (Datenkorrektheit) als eine der drei grundlegenden Eigenschaften, die jedes Informationssicherheitsprogramm schützen muss.
Sowohl ISO/IEC 27000 als auch das NIST Cybersecurity Framework benennen Verfügbarkeit als zentrales Sicherheitsziel. Das NIST National Cybersecurity Center of Excellence formuliert es so: Systeme, Informationen, Anwendungen und Dienste müssen für autorisierte Nutzer zugänglich und funktionsfähig bleiben, wenn diese sie benötigen. Bedrohungen, die gezielt auf die Verfügbarkeit abzielen, umfassen Denial-of-Service-Angriffe, Ransomware, Kapazitätserschöpfung und Ausfälle ganzer Cloud-Regionen.
Praxisnahe IT-Anwendungsfälle, bei denen Verfügbarkeit die primäre Anforderung ist:
- Eine Webanwendung, die Kunden rund um die Uhr bedienen muss
- Eine Datenbank, die Abfragen innerhalb definierter Latenzgrenzen beantworten muss
- Eine API, von der nachgelagerte Dienste Echtzeitdaten beziehen
- Backup-Systeme, die Daten innerhalb eines definierten Recovery-Fensters wiederherstellen müssen
- Authentifizierungsdienste, deren Ausfall alle Nutzer aus sämtlichen Systemen aussperrt
Dieser letzte Punkt ist wichtiger, als die meisten Teams erkennen. Sicherheitsmaßnahmen können im Konflikt mit der Verfügbarkeit stehen: Zu restriktive Zugriffsrichtlinien oder schlecht implementierte Multi-Faktor-Authentifizierung können zu Aussperrungen führen, die legitimen Nutzern den Zugang verweigern. Verfügbarkeit ist nicht nur ein Betriebsanliegen – sie ist in beide Richtungen eine Sicherheitsfrage.
Wie wird Verfügbarkeit gemessen?
Verfügbarkeit wird als prozentualer Anteil der Gesamtzeit ausgedrückt, in der ein System betriebsbereit und nutzbar ist. Die Standardformel lautet:
Verfügbarkeit (%) = (Gesamtzeit − Ausfallzeit) / Gesamtzeit × 100
Die „Neunen"-Kurzschreibweise
Die branchenübliche Kurzschreibweise „Neunen" beschreibt, wie viele Neunen nach dem Komma stehen. Mehr Neunen bedeuten weniger zulässige Ausfallzeit pro Jahr:
| Verfügbarkeit | „Neunen" | Max. Ausfallzeit pro Jahr |
|---|---|---|
| — | Zwei Neunen | einige Tage |
| — | Drei Neunen | weniger als einen halben Tag |
| 99.— | Vier Neunen | unter einer Stunde |
| — | Fünf Neunen | nur wenige Minuten |
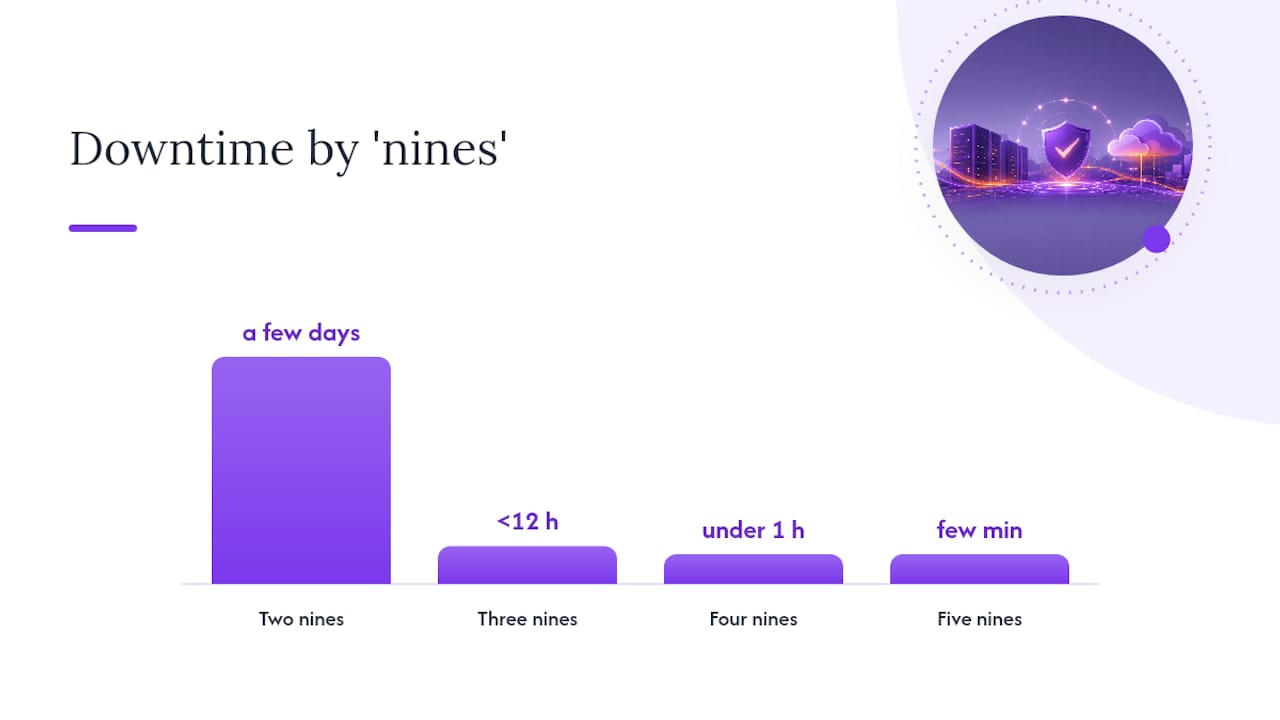
Der Schritt von drei auf vier Neunen reduziert die zulässige Ausfallzeit erheblich. Diese Lücke klingt handhabbar, bis man sie in entgangenen Transaktionen für einen Zahlungsdienstleister oder SLA-Vertragsstrafen für einen Managed Service Provider bewertet.
SLA, RTO und RPO
Ein SLA (Service Level Agreement) ist die vertragliche Zusage, die den minimal akzeptablen Verfügbarkeitsprozentsatz definiert – häufig verbunden mit finanziellen Sanktionen bei Verstößen.
Der RTO (Recovery Time Objective) ist die maximal akzeptable Wiederherstellungszeit nach einem Ausfall. Der RPO (Recovery Point Objective) ist der maximal akzeptable Datenverlust, gemessen in Zeit – also wie weit zurück ein Rollback akzeptiert werden kann.
Ihr RTO beträgt 4 Stunden pro Vorfall und ihr RPO 1 Stunde. Das bedeutet: Jeder Ausfall muss innerhalb von 4 Stunden behoben sein, und es darf nicht mehr als 1 Stunde an Daten verloren gehen. Bei drei Vorfällen pro Jahr, die jeweils den vollen 4-Stunden-RTO in Anspruch nehmen, ist das jährliche Ausfall-Budget in drei Ereignissen erschöpft.
RTO und RPO sind nicht dasselbe wie der Verfügbarkeitsprozentsatz. Sie beschreiben wie schnell man sich erholt und wie viel Daten verloren gehen, während der Verfügbarkeitsprozentsatz beschreibt, wie oft das System in Betrieb ist. Alle drei gehören in jedes ernsthafte Gespräch über Verfügbarkeit.
Wie halten Organisationen Systeme verfügbar?
Verfügbarkeit entsteht nicht von selbst. Sie erfordert bewusste technische Entscheidungen, die über Infrastruktur, Architektur und Betrieb hinweg aufeinander abgestimmt sind.
Grundlegende technische Maßnahmen:
- Redundanz: Duplizierung von Komponenten (Server, Netzteile, Netzwerkpfade), damit ein einzelner Ausfall das System nicht zum Erliegen bringt
- Load Balancing: Verteilung des Datenverkehrs auf mehrere Instanzen, sodass kein einzelner Knoten zum Engpass wird
- Autoscaling: Automatisches Hinzufügen von Kapazität bei Lastspitzen, um Kapazitätserschöpfung zu verhindern
- Failover: Automatische Umleitung des Datenverkehrs auf eine funktionierende Instanz, wenn die primäre ausfällt
- Geografische Replikation: Kopieren von Daten und Diensten über mehrere Regionen oder Rechenzentren hinweg
- Health Checks und Monitoring: Kontinuierliche Überwachung von Diensten mit Alarmierung bei Anomalien, bevor Nutzer sie bemerken
- Getestete Backups: Backups, die nie wiederhergestellt wurden, sind keine Backups – sie sind Hoffnungen
Architekturmuster übersetzen diese Maßnahmen in konkrete Systemdesigns. Ein Active-Active-Setup betreibt zwei oder mehr identische Instanzen gleichzeitig, teilt die Last und ermöglicht sofortiges Failover. Ein Active-Passive-Setup hält eine Standby-Instanz bereit, die beim Ausfall der primären Instanz übernimmt – mit einer kurzen Umschaltverzögerung. Graceful Degradation ermöglicht es einem System, unter Last nicht-kritische Funktionen abzuschalten, anstatt vollständig auszufallen, und so die Kernfunktionalität aufrechtzuerhalten.
Praxistipp: Bevor Sie in geografische Replikation investieren, kartieren Sie Ihren Abhängigkeitsgraphen. Ein hochverfügbares Web-Tier, das auf einer Single-Region-Datenbank aufbaut, hat nach wie vor einen Single Point of Failure. Replikation auf der falschen Ebene verschwendet Budget, ohne die tatsächliche Verfügbarkeit zu verbessern.
Wie unterscheidet sich Verfügbarkeit von Disaster Recovery?
Diese drei Konzepte sind verwandt, lösen aber unterschiedliche Probleme – und ihre Vermischung führt zu Fehlinvestitionen.
| Konzept | Fokus | Auslöser | Typische Werkzeuge |
|---|---|---|---|
| Hochverfügbarkeit | Ausfallzeiten im Normalbetrieb verhindern | Routineausfälle, Lastspitzen | Redundanz, Failover, Autoscaling |
| Disaster Recovery | Betrieb nach einem Großereignis wiederherstellen | Katastrophaler Ausfall, Verlust eines Rechenzentrums | Backups, DR-Standort, Runbooks |
| Business Continuity | Kritische Geschäftsfunktionen aufrechterhalten | Jede größere Störung | DR + manuelle Workarounds + Kommunikationspläne |
Der AWS Well-Architected Reliability Pillar zieht diese Grenze klar: Hochverfügbarkeits-Engineering behandelt alltägliche Störungen; Disaster Recovery behandelt katastrophale. Beide erfordern unterschiedliche Investitionen und unterschiedliche Testkadenz.
Hochverfügbarkeitsmaßnahmen einsetzen, wenn:
- Ausfälle häufig, vorhersehbar oder klein im Umfang sind (ein einzelner Serverabsturz, ein kurzer Netzwerkausfall)
- Die Wiederherstellung automatisch und nahezu sofortig erfolgen muss
- Die Kosten der Ausfallzeit pro Stunde die Kosten der redundanten Infrastruktur übersteigen
Zur vollständigen DR-Planung eskalieren, wenn:
- Eine ganze Region, ein Rechenzentrum oder ein System gleichzeitig ausfallen könnte
- Die Wiederherstellung menschliches Eingreifen und teamübergreifende Koordination erfordert
- Regulatorische Anforderungen getestete Wiederherstellungsverfahren mit dokumentierten RTO/RPO vorschreiben
Ein praktischer Hinweis: Geplante Wartungsfenster werden aus SLA-Verfügbarkeitsberechnungen häufig ausgeschlossen. Fragen Sie immer, welchen Messzeitraum eine Verfügbarkeitsangabe abdeckt und welche Ausschlüsse gelten, bevor Sie eine solche Angabe für bare Münze nehmen.
Was sind die häufigsten Bedrohungen für die Verfügbarkeit?
Verfügbarkeitsausfälle entstehen aus zwei breiten Kategorien: gezielten Angriffen und unbeabsichtigten Fehlern. Beide können katastrophale Folgen haben – sie erfordern nur unterschiedliche Gegenmaßnahmen.
Gezielte Bedrohungen:
- Distributed Denial-of-Service (DDoS)-Angriffe: Überflutung eines Dienstes mit Datenverkehr, bis er auf legitime Anfragen nicht mehr reagieren kann
- Ransomware: Verschlüsselt Daten oder Systeme und macht sie unzugänglich, bis ein Lösegeld gezahlt oder Backups eingespielt werden
- Aussperrungen durch Anmeldedaten: Angreifer lösen Konto-Sperrmechanismen aus, um legitimen Nutzern den Zugang zu verweigern
Unbeabsichtigte Ursachen:
- Hardwareausfall: Eine Festplatte, ein Netzteil oder eine Netzwerkkarte fällt ohne Vorwarnung aus
- Software-Fehler: Ein fehlerhaftes Deployment führt zu einer Absturz-Schleife oder einem Speicherleck
- Kapazitätserschöpfung: Datenverkehr wächst schneller als die Infrastruktur skaliert, was zu Timeouts und Fehlern führt
- Abgelaufene Zertifikate: Ein TLS-Zertifikat läuft ab und Browser blockieren den Zugang zum Dienst
- Menschliche Fehler während der Wartung: Eine falsch konfigurierte Firewall-Regel, eine gelöschte Datenbanktabelle oder ein gescheiterter Deployment-Rollback
- Single Points of Failure: Jede Komponente ohne redundantes Pendant, deren Ausfall das gesamte System lahmlegt
Der wesentliche Unterschied zwischen Angriffen und Unfällen liegt in der Absicht, aber die betrieblichen Auswirkungen sind oft identisch. Ein Ransomware-Angriff und eine misslungene Datenbankmigration können beide zu stundenlangen Ausfällen führen. Der Unterschied zeigt sich in der Reaktion: Ein Angriff erfordert Incident Response und forensische Analyse; ein Unfall erfordert einen Rollback und eine Post-mortem-Analyse.
Wie sollten Verfügbarkeitsziele aus dem Business Impact abgeleitet werden?
Fünf Neunen anzustreben, weil ein Mitbewerber sie beansprucht, ist ein verbreiteter und kostspieliger Fehler. Die AWS Well-Architected Guidance ist eindeutig: Verfügbarkeitsziele aus dem geschäftlichen Auswirkungen ableiten, nicht aus marktüblichen Uptime-Prozentzahlen.
Eine wiederholbare Methode:
- Kritische Geschäftsprozesse identifizieren. Welche Prozesse stoppen bei Unterbrechung direkt den Umsatz, schaden Kunden oder lösen regulatorische Sanktionen aus?
- Kosten der Ausfallzeit pro Stunde schätzen. Entgangene Umsätze, Support-Kosten, SLA-Strafen und Reputationsschäden einbeziehen.
- Diesen Betrag auf RTO und RPO abbilden. Wenn eine Stunde Ausfallzeit 50.000 Euro kostet, sollte der RTO deutlich unter einer Stunde liegen. Wenn der Verlust von 24 Stunden Transaktionsdaten katastrophal wäre, muss der RPO in Minuten gemessen werden.
- Das Infrastrukturmuster auswählen, das diese Ziele erfüllt. Die Architektur an die Anforderung anpassen – nicht umgekehrt.
- Die Lücke bepreisen. Active-Active Multi-Region ist deutlich teurer als Active-Passive Single-Region. Übersteigen die Architekturkosten die Kosten der verhinderten Ausfallzeit, sollten die Ziele überdacht werden.
Drei Beispiele aus der Praxis:
- Interne Admin-Anwendung: Ausfallzeit ist unangenehm, aber nicht umsatzrelevant. Ein RTO von 4 Stunden und ein einfaches Active-Passive-Setup mit täglichen Backups ist verhältnismäßig.
- Öffentlicher E-Commerce-Shop: Jede Stunde Ausfallzeit kostet echten Umsatz. Ein RTO von 15 Minuten, ein RPO von 5 Minuten und eine Active-Active-Architektur mit Echtzeit-Replikation ist gerechtfertigt.
- Regulierter Finanzdienstleister: Ausfallzeiten lösen Meldepflichten gegenüber Aufsichtsbehörden und mögliche Bußgelder aus. RTO in Sekunden, RPO nahe null und geografische Redundanz mit geprüftem Failover sind Mindestvoraussetzung.
Praxistipp: Beziehen Sie geplante Wartungsfenster von Anfang an in Ihre SLA-Berechnung ein. Verhandeln Sie entweder ausdrücklich Wartungsausschlüsse oder bauen Sie Zero-Downtime-Deployment-Pipelines auf.
Eine praktische Verfügbarkeits-Checkliste für Ihr Team
Die richtigen Maßnahmen hängen von Ihrer Größe und Ihrem Risikoprofil ab. Beginnen Sie dort, wo Sie stehen.
Kleines Team oder Start-up:
- Identifizieren Sie die drei Dienste, ohne die Ihr Unternehmen nicht funktionieren kann.
- Stellen Sie sicher, dass jeder davon ein getestetes Backup und eine dokumentierte Wiederherstellungsprozedur hat.
- Richten Sie Uptime-Monitoring ein (auch ein kostenloses Tool genügt) mit Alarmierung auf ein Telefon oder einen Slack-Kanal.
- Schreiben Sie für jeden kritischen Dienst einen einseitigen Runbook: Was tun, wenn er ausfällt, wen anrufen und wo die Backups liegen.
- Prüfen Sie das SLA Ihres Hosting-Anbieters und notieren Sie, was ausgeschlossen ist.
Mittelständische Organisation:
- Führen Sie ein Abhängigkeitsinventar durch: Kartieren Sie, welche Dienste von welchen anderen abhängen, und identifizieren Sie Single Points of Failure.
- Definieren Sie RTO und RPO für jedes kritische System und prüfen Sie, ob Ihre aktuelle Architektur diese Ziele erfüllen kann.
- Testen Sie die Backup-Wiederherstellung vierteljährlich – nicht nur die Backup-Erstellung.
- Implementieren Sie Health Checks und automatisierte Alarmierung mit Eskalationspfaden.
- Überprüfen Sie Anbieter-SLAs jährlich und gleichen Sie diese mit Ihren internen RTO/RPO-Zielen ab.
Enterprise:
- Führen Sie Tabletop-Übungen durch, die Verfügbarkeitsausfälle simulieren – einschließlich Ransomware-Szenarien.
- Pflegen Sie eine formale Business Impact Analysis (BIA), die Prozesse dem finanziellen Auswirkungspotenzial zuordnet und direkt in RTO/RPO-Ziele einfließt.
- Trennen Sie Hochverfügbarkeits-Engineering von Disaster-Recovery-Planung mit eigenen Verantwortlichen, Budgets und Testzeitplänen.
- Prüfen Sie SLA-Ausschlüsse aller kritischen Anbieter und konsolidieren Sie das Reporting in einem zentralen Verfügbarkeits-Dashboard.
- Richten Sie Verfügbarkeitsmaßnahmen am Scope Ihrer ISO 27001-Zertifizierung und Ihrem Statement of Applicability aus.
Der wirkungsvollste Quick Win für jede Teamgröße: Testen Sie Ihre Backups heute. Nicht nächstes Quartal. Heute. Ein Backup, das noch nie wiederhergestellt wurde, ist eine ungeprüfte Annahme – und ungeprüfte Annahmen sind der Punkt, an dem Verfügbarkeitspläne scheitern.
Warum Verfügbarkeitsplanung heute alle angeht – nicht nur das Operations-Team
Das alte Denkmodell verortete Verfügbarkeit klar beim Infrastruktur-Team. Ops hielt den Betrieb aufrecht; Security hielt Angreifer fern; das Business setzte die SLAs und hoffte das Beste. Diese Trennung gilt nicht mehr – und der Grund dafür ist Ransomware.
Wenn ein Angreifer Ihre Systeme verschlüsselt und Zahlung verlangt, stiehlt er keine Daten im klassischen Sinne. Er greift die Verfügbarkeit an. Die CIA-Triade macht dies explizit: Vertraulichkeit, Integrität und Verfügbarkeit sind gleichwertige Sicherheitseigenschaften. Dennoch behandeln die meisten Organisationen Verfügbarkeit weiterhin als Zuverlässigkeitskennzahl und Vertraulichkeit als die eigentliche Sicherheitskennzahl. Diese Trennung hinterlässt eine Lücke, die Angreifer gezielt ausnutzen.
Die NIST-Leitlinien zu Industrie-4.0-Cybersicherheit bringen den Integrationspunkt klar zum Ausdruck: Moderne Resilienzplanung muss Informationssicherheit, IT-Betrieb und Business Continuity zusammenbringen, da Bedrohungen keine Organisationsgrenzen respektieren. Ein Ransomware-Vorfall ist gleichzeitig ein Sicherheitsereignis, ein Verfügbarkeitsausfall und eine Business-Continuity-Krise. Die Reaktion darauf erfordert alle drei Disziplinen, die nach demselben Playbook arbeiten.
Was meiner Erfahrung nach konsequent unterschätzt wird, ist der Einfluss der Business Impact Analysis auf alles Nachgelagerte. Teams verbringen Wochen damit zu debattieren, ob sie Active-Active oder Active-Passive aufbauen sollen, während die eigentliche Frage lautet: Was kostet eine Stunde Ausfallzeit dieses Unternehmen tatsächlich? Wer das ehrlich beantwortet, dem zeigt sich die Architekturentscheidung meist von selbst. Der Vergleich zwischen ISO 27001 und NIST ist lesenswert, wenn Sie entscheiden möchten, an welchem Framework Sie Ihre Verfügbarkeitsmaßnahmen ausrichten wollen – da beide Frameworks Verfügbarkeit in Umfang und Prüfanforderungen unterschiedlich behandeln.
Der praktische nächste Schritt ist überschaubar: Wählen Sie einen kritischen Geschäftsprozess, schätzen Sie, was eine Stunde Ausfallzeit kostet, und leiten Sie daraus einen RTO ab. Diese eine Übung sagt Ihnen mehr über Ihre tatsächlichen Verfügbarkeitsanforderungen als jede Uptime-Marketing-Seite eines Anbieters.

Wenn Ihre Organisation Verfügbarkeitsanforderungen in eine ISO 27001-Implementierung einarbeitet, übersetzt der ISO 27001 Readiness Assessment von Ismscalculator Ihre Sicherheitsmaßnahmen – einschließlich Verfügbarkeit – in eine maßgeschneiderte Kosten- und Aufwandsschätzung. Sie können auch eine kostenlose 2-Minuten-Bereitschaftsprüfung durchführen, um zu sehen, wo Ihr aktueller Stand über alle vier Kontrollthemen der ISO/IEC 27001:2022 liegt, bevor Sie sich auf einen vollständigen Implementierungsplan festlegen.