Disponibilidad significa la cualidad o estado de estar listo, accesible y utilizable cuando se necesita. Merriam-Webster la define simplemente como "la cualidad o estado de estar disponible", y esa definición se aplica tanto si se habla de una cita libre como de una base de datos en producción. En seguridad de la información, la disponibilidad es el tercer pilar de la tríada CIA junto con la confidencialidad y la integridad. Tanto ISO/IEC 27000 como el NIST Cybersecurity Framework la tratan como una propiedad de seguridad formal: los sistemas, servicios y datos deben permanecer operativos para los usuarios autorizados cuando los necesiten. Cuando falla la disponibilidad, las organizaciones pierden ingresos, confianza y, en ocasiones, su posición regulatoria.
Conclusiones clave
Disponibilidad significa que un sistema, servicio o recurso está listo y puede utilizarse cuando se necesita, y las organizaciones deben medirla, diseñarla y protegerla tanto como propiedad operativa como de seguridad.
| Punto | Detalles |
|---|---|
| Definición central | La disponibilidad es la cualidad o estado de estar listo y accesible, y el tercer pilar de la tríada CIA en seguridad de la información. |
| Fórmula de medición | Disponibilidad % = (Tiempo total − Tiempo de inactividad) / Tiempo total × 100; permite aproximadamente 8,76 horas de inactividad al año. |
| Establecer objetivos según el impacto | Derive el RTO y el RPO del coste de la inactividad por hora, no persiguiendo los "nueves" más llamativos. |
| Controles clave | La redundancia, la conmutación por error, las copias de seguridad probadas, la monitorización y los runbooks son los principales mecanismos de ingeniería. |
| Alineación con estándares | Tanto ISO/IEC 27000 como el NIST Cybersecurity Framework tratan la disponibilidad como un requisito de seguridad formal junto con la confidencialidad y la integridad. |
Tabla de contenidos
- ¿Qué significa disponibilidad en el lenguaje cotidiano?
- Cómo se define la disponibilidad en TI y seguridad de la información
- ¿Cómo se mide la disponibilidad?
- ¿Cómo mantienen las organizaciones los sistemas disponibles?
- ¿En qué se diferencia la disponibilidad de la recuperación ante desastres?
- ¿Cuáles son las amenazas más comunes para la disponibilidad?
- ¿Cómo establecer objetivos de disponibilidad a partir del impacto en el negocio?
- Una lista de verificación práctica de disponibilidad para su equipo
- Por qué la planificación de la disponibilidad le corresponde a todos, no solo al equipo de operaciones
- Fuentes
¿Qué significa disponibilidad en el lenguaje cotidiano?
En su acepción más básica, disponibilidad es la cualidad o estado de ser fácilmente obtenible, accesible o estar listo para uso inmediato. El Cambridge Dictionary lo define como "el hecho de que algo se puede comprar, usar o alcanzar, o cuánto de ello existe". Ambas definiciones apuntan a la misma idea central: algo está disponible cuando se puede acceder a ello, usarlo o comprarlo en este momento.
Los ejemplos cotidianos concretan el concepto rápidamente:
- "Tengo disponibilidad el jueves por la tarde" significa que tiene franjas horarias libres que otros pueden reservar.
- "Sujeto a disponibilidad" en una página de producto significa que el stock puede agotarse antes de que se procese su pedido.
- "El servicio está disponible 24/7" significa que opera de forma continua sin cierres programados.
- "Disponibilidad limitada" en un sitio de entradas de concierto indica escasez, no un fallo técnico.
- "El medicamento está disponible sin receta" significa que no se necesita prescripción médica para obtenerlo.
Nótese que disponibilidad en el habla común suele confundirse con accesibilidad. Dictionary.com señala que ambos términos se usan indistintamente en frases como "La accesibilidad de Internet ha aumentado la disponibilidad de información". Están relacionados, pero no son idénticos: la accesibilidad se refiere a menudo a si se puede llegar a algo en absoluto, mientras que la disponibilidad añade la dimensión de preparación y cantidad.
Consejo práctico: Al programar reuniones, sustituya "dígame su disponibilidad" por una franja concreta: "Estoy libre el martes de 10 a 11 h o el miércoles de 14 a 15 h." Las solicitudes de disponibilidad vagas generan tres rondas de intercambios; una franja específica suele resolverse en uno.
Cómo se define la disponibilidad en TI y seguridad de la información
En TI y seguridad, la disponibilidad tiene un significado preciso respaldado por estándares. La tríada CIA la define como la garantía de que los usuarios autorizados pueden acceder a los sistemas y datos cuando los necesitan, con un rendimiento aceptable. Se sitúa junto a la confidencialidad (mantener los datos privados) y la integridad (mantener los datos exactos) como una de las tres propiedades fundamentales que todo programa de seguridad de la información debe proteger.
Tanto ISO/IEC 27000 como el NIST Cybersecurity Framework invocan la disponibilidad como un objetivo de seguridad central. El Centro Nacional de Excelencia en Ciberseguridad del NIST lo enmarca así: los sistemas, la información, las aplicaciones y los servicios deben permanecer accesibles y funcionales para los usuarios autorizados cuando los necesiten. Las amenazas que apuntan específicamente a la disponibilidad incluyen los ataques de denegación de servicio, el ransomware, el agotamiento de la capacidad y los fallos de regiones en la nube.
Casos de uso prácticos en TI donde la disponibilidad es la preocupación principal:
- Una aplicación web que debe atender a clientes las 24 horas del día
- Una base de datos que debe responder a consultas dentro de umbrales de latencia definidos
- Una API de la que dependen servicios externos para obtener datos en tiempo real
- Sistemas de copia de seguridad que deben restaurar datos dentro de una ventana de recuperación definida
- Servicios de autenticación que, si no están disponibles, bloquean a todos los usuarios de todos los sistemas
Este último punto importa más de lo que la mayoría de los equipos reconoce. Los controles de seguridad pueden entrar en conflicto con la disponibilidad: políticas de acceso excesivamente estrictas o una autenticación multifactor mal implementada pueden provocar bloqueos que denieguen el acceso a usuarios legítimos. La disponibilidad no es solo una preocupación operativa; es una preocupación de seguridad en ambas direcciones.
¿Cómo se mide la disponibilidad?
La disponibilidad se expresa como un porcentaje del tiempo total en que un sistema está operativo y utilizable. La fórmula estándar es:
Disponibilidad (%) = (Tiempo total − Tiempo de inactividad) / Tiempo total × 100
La abreviatura de los "nueves"
La abreviatura del sector "nueves" describe cuántos nueves aparecen tras el punto decimal. Un mayor número de nueves implica menos tiempo de inactividad permitido por año:
| Disponibilidad | "Nueves" | Tiempo de inactividad máximo por año |
|---|---|---|
| — | Dos nueves | varios días |
| — | Tres nueves | menos de medio día |
| 99.— | Cuatro nueves | menos de una hora |
| — | Cinco nueves | solo unos minutos |
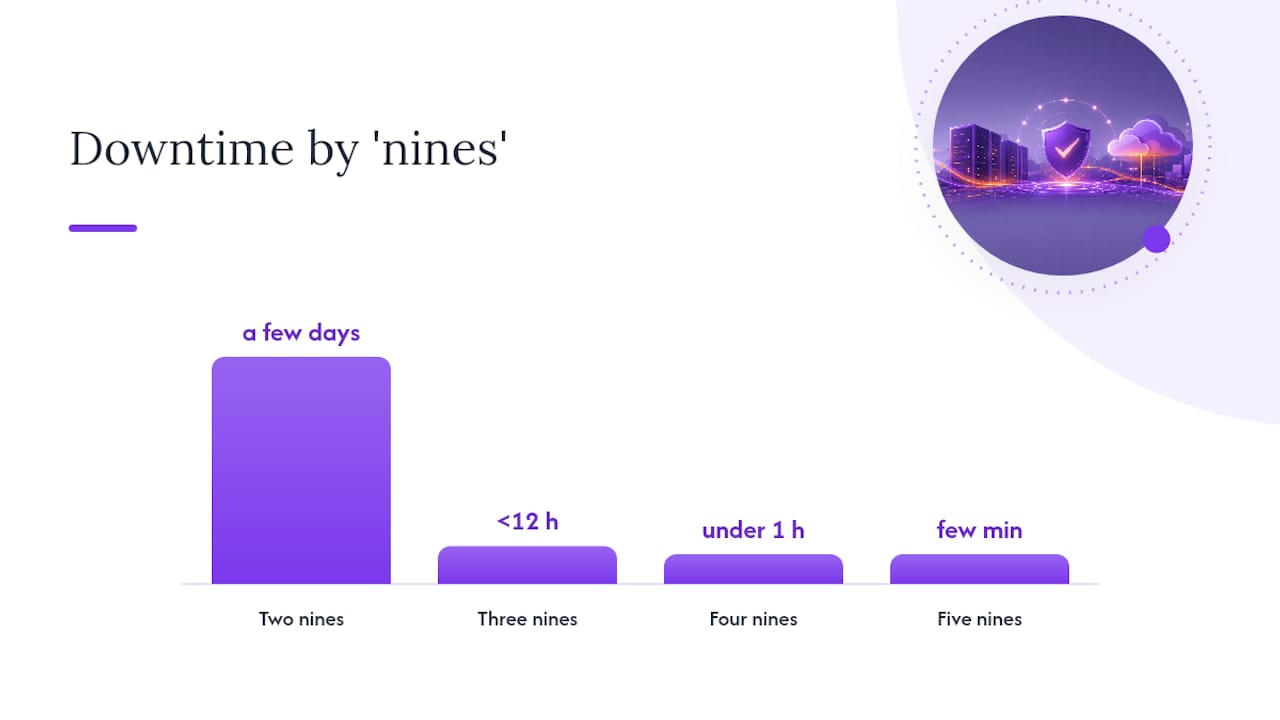
Pasar de tres nueves a cuatro nueves reduce drásticamente el tiempo de inactividad permitido. Esa diferencia parece manejable hasta que se calcula en transacciones perdidas para un procesador de pagos o en penalizaciones por incumplimiento de SLA para un proveedor de servicios gestionados.
SLA, RTO y RPO
Un SLA (Acuerdo de Nivel de Servicio) es el compromiso contractual que define el porcentaje mínimo de disponibilidad aceptable, a menudo con penalizaciones económicas en caso de incumplimiento.
El RTO (Objetivo de Tiempo de Recuperación) es el tiempo máximo aceptable para restaurar un sistema tras un fallo. El RPO (Objetivo de Punto de Recuperación) es la pérdida máxima de datos aceptable medida en tiempo, es decir, hasta qué punto se puede retroceder en la restauración.
Su RTO es de 4 horas por incidente y su RPO es de 1 hora. Eso significa que cada fallo debe resolverse en 4 horas y no puede perderse más de 1 hora de datos. Si experimentan tres incidentes al año, cada uno consumiendo el RTO completo de 4 horas, agotan su presupuesto anual de inactividad en tres eventos.
El RTO y el RPO no son lo mismo que el porcentaje de disponibilidad. Describen qué tan rápido se recupera y cuántos datos se pierden, mientras que el porcentaje de disponibilidad describe con qué frecuencia el sistema está activo. Los tres deben figurar en cualquier conversación seria sobre disponibilidad.
¿Cómo mantienen las organizaciones los sistemas disponibles?
La disponibilidad no ocurre por accidente. Requiere decisiones de ingeniería deliberadas que se superponen en infraestructura, arquitectura y operaciones.
Controles técnicos principales:
- Redundancia: componentes duplicados (servidores, fuentes de alimentación, rutas de red) para que un único fallo no deje el sistema fuera de servicio
- Balanceo de carga: distribuir el tráfico entre varias instancias para que ningún nodo se convierta en un cuello de botella
- Escalado automático: añadir capacidad automáticamente cuando la demanda se dispara, evitando el agotamiento de recursos
- Conmutación por error (failover): redirigir automáticamente el tráfico a una instancia en buen estado cuando falla la principal
- Replicación geográfica: copiar datos y servicios en varias regiones o centros de datos
- Comprobaciones de estado y monitorización: sondear continuamente los servicios y alertar sobre anomalías antes de que los usuarios las noten
- Copias de seguridad probadas: las copias de seguridad que nunca se han restaurado no son copias de seguridad; son esperanzas
Los patrones de arquitectura trasladan estos controles a diseños de sistemas. Una configuración activo-activo ejecuta dos o más instancias idénticas simultáneamente, compartiendo carga y proporcionando conmutación por error instantánea. Una configuración activo-pasivo mantiene una instancia en espera lista para tomar el relevo cuando falla la principal, con un breve retraso de conmutación. La degradación elegante permite que un sistema abandone funciones no críticas bajo presión en lugar de fallar por completo, manteniendo operativa la funcionalidad esencial.
Consejo práctico: Antes de invertir en replicación geográfica, mapee su grafo de dependencias. Un nivel web de alta disponibilidad respaldado por una base de datos en una única región sigue teniendo un único punto de fallo. La replicación en la capa incorrecta desperdicia presupuesto sin mejorar la disponibilidad real.
¿En qué se diferencia la disponibilidad de la recuperación ante desastres?
Estos tres conceptos están relacionados, pero resuelven problemas diferentes, y confundirlos lleva a una asignación incorrecta de presupuestos.
| Concepto | Enfoque | Desencadenante | Herramientas típicas |
|---|---|---|---|
| Alta disponibilidad | Prevenir el tiempo de inactividad durante las operaciones normales | Fallos rutinarios, picos de tráfico | Redundancia, failover, escalado automático |
| Recuperación ante desastres | Restaurar las operaciones tras un evento mayor | Fallo catastrófico, pérdida de centro de datos | Copias de seguridad, sitio de DR, runbooks |
| Continuidad del negocio | Mantener en funcionamiento las funciones críticas del negocio | Cualquier interrupción importante | DR + soluciones manuales + planes de comunicación |
El pilar de Fiabilidad del AWS Well-Architected traza esta línea con claridad: la ingeniería de disponibilidad gestiona las interrupciones cotidianas; la recuperación ante desastres gestiona las catastróficas. Ambas requieren inversiones diferentes y cadencias de prueba diferentes.
Use controles de alta disponibilidad cuando:
- Los fallos son frecuentes, predecibles o de pequeño alcance (un fallo de servidor, una interrupción de red)
- La recuperación debe ser automática y casi instantánea
- El coste de la inactividad por hora supera el coste de la infraestructura redundante
Escale a una planificación completa de DR cuando:
- Una región, centro de datos o sistema completo podría perderse simultáneamente
- La recuperación requiere intervención humana y coordinación entre equipos
- Los requisitos regulatorios exigen procedimientos de recuperación probados con RTO/RPO documentados
Una nota práctica: las ventanas de mantenimiento planificado suelen excluirse de los cálculos de disponibilidad del SLA. Pregunte siempre qué cubre el período de medición y qué exclusiones se aplican antes de aceptar una declaración de disponibilidad a valor nominal.
¿Cuáles son las amenazas más comunes para la disponibilidad?
La pérdida de disponibilidad proviene de dos grandes categorías: ataques deliberados y fallos accidentales. Ambos pueden ser catastróficos; simplemente requieren mitigaciones diferentes.
Amenazas deliberadas:
- Ataques de denegación de servicio distribuido (DDoS): saturan un servicio con tráfico hasta que no puede responder a las solicitudes legítimas
- Ransomware: cifra datos o sistemas, haciéndolos inaccesibles hasta que se paga un rescate o se restauran las copias de seguridad
- Bloqueos basados en credenciales: los atacantes activan políticas de bloqueo de cuentas para denegar el acceso a usuarios legítimos
Causas accidentales:
- Fallo de hardware: un disco, una fuente de alimentación o una tarjeta de red falla sin previo aviso
- Errores de software: un despliegue defectuoso introduce un bucle de caídas o una fuga de memoria
- Agotamiento de la capacidad: el tráfico crece más rápido de lo que escala la infraestructura, provocando tiempos de espera y errores
- Certificados expirados: un certificado TLS caduca y los navegadores bloquean el acceso al servicio
- Error humano durante el mantenimiento: una regla de firewall mal configurada, una tabla de base de datos eliminada o una reversión de despliegue fallida
- Puntos únicos de fallo: cualquier componente sin redundancia que, al fallar, deja caído todo el sistema
La distinción clave entre ataques y accidentes es la intención, pero el impacto operativo suele ser idéntico. Un ataque de ransomware y una migración de base de datos fallida pueden producir horas de inactividad. La diferencia aparece en la respuesta: un ataque requiere respuesta a incidentes y análisis forense; un accidente requiere una reversión y un post-mortem.
¿Cómo establecer objetivos de disponibilidad a partir del impacto en el negocio?
Perseguir cinco nueves porque un competidor los declara es un error común y costoso. La guía del AWS Well-Architected es directa: derive los objetivos de disponibilidad del impacto en el negocio, no de porcentajes de tiempo de actividad con fines de marketing.
Un método repetible:
- Identifique sus procesos de negocio críticos. ¿Qué procesos, si se interrumpen, detienen directamente los ingresos, perjudican a los clientes o desencadenan penalizaciones regulatorias?
- Estime el coste de la inactividad por hora. Incluya los ingresos perdidos, los costes de soporte, las penalizaciones por SLA y el impacto reputacional.
- Traslade ese coste a un RTO y un RPO. Si una hora de inactividad cuesta 50 000 €, su RTO debe ser muy inferior a una hora. Si perder 24 horas de datos de transacciones es catastrófico, su RPO debe medirse en minutos.
- Seleccione el patrón de infraestructura que cumpla esos objetivos. Adapte la arquitectura al requisito, y no al revés.
- Evalúe la diferencia de coste. Activo-activo multirregión cuesta significativamente más que activo-pasivo en una sola región. Si el coste de la arquitectura supera el coste de la inactividad que previene, reconsidere el objetivo.
Tres ejemplos de cómo se aplica esto en la práctica:
- Aplicación de administración interna: la inactividad es incómoda pero no afecta a los ingresos. Un RTO de 4 horas y una configuración activo-pasivo sencilla con copias de seguridad diarias es proporcionado.
- Sitio de comercio electrónico público: cada hora de inactividad supone ingresos reales perdidos. Un RTO de 15 minutos, un RPO de 5 minutos y una arquitectura activo-activo con replicación en tiempo real está justificado.
- Servicio financiero regulado: la inactividad desencadena obligaciones de notificación regulatoria y posibles multas. RTO medido en segundos, RPO cercano a cero, y redundancia geográfica con failover probado son requisitos mínimos.
Consejo práctico: Incluya el mantenimiento planificado en sus cálculos de SLA desde el primer día. Negocie explícitamente exclusiones de mantenimiento o construya canalizaciones de despliegue sin tiempo de inactividad.
Una lista de verificación práctica de disponibilidad para su equipo
Los controles adecuados dependen de su tamaño y perfil de riesgo. Empiece desde donde está.
Equipo pequeño o startup:
- Identifique los tres servicios sin los cuales su negocio no puede funcionar.
- Confirme que cada uno tiene una copia de seguridad probada y un procedimiento de restauración documentado.
- Configure una monitorización de tiempo de actividad (incluso con una herramienta gratuita) con alertas a un teléfono o canal de Slack.
- Escriba un runbook de una página para cada servicio crítico: qué hacer cuando falla, a quién llamar y dónde están las copias de seguridad.
- Revise el SLA de su proveedor de alojamiento y anote qué está excluido.
Organización mediana:
- Realice un inventario de dependencias: mapee qué servicios dependen de cuáles y detecte los puntos únicos de fallo.
- Defina el RTO y el RPO para cada sistema crítico y verifique que su arquitectura actual puede cumplirlos.
- Pruebe la restauración de copias de seguridad trimestralmente, no solo su creación.
- Implemente comprobaciones de estado y alertas automatizadas con rutas de escalada.
- Revise los SLA de proveedores anualmente y alinéelos con sus objetivos internos de RTO/RPO.
Empresa grande:
- Realice ejercicios de mesa que simulen fallos de disponibilidad, incluidos escenarios de ransomware.
- Mantenga un análisis de impacto en el negocio (BIA) formal que mapee los procesos hacia el impacto financiero y alimente directamente los objetivos de RTO/RPO.
- Separe la ingeniería de alta disponibilidad de la planificación de recuperación ante desastres con responsables, presupuestos y calendarios de prueba distintos.
- Audite las exclusiones de SLA de todos los proveedores críticos y consolide los informes en un único panel de disponibilidad.
- Alinee los controles de disponibilidad con el alcance de su certificación ISO 27001 y la Declaración de Aplicabilidad.
La mejor acción rápida para cualquier tamaño de equipo: pruebe sus copias de seguridad hoy. No el próximo trimestre. Hoy. Una copia de seguridad que nunca se ha restaurado es una suposición no verificada, y las suposiciones no verificadas son donde fallan los planes de disponibilidad.
Por qué la planificación de la disponibilidad le corresponde a todos, no solo al equipo de operaciones
El antiguo modelo mental situaba la disponibilidad exclusivamente en el equipo de infraestructura. Operaciones mantenía las luces encendidas; seguridad mantenía a los actores maliciosos fuera; el negocio fijaba los SLA y esperaba lo mejor. Esa separación ya no se sostiene, y el motivo es el ransomware.
Cuando un atacante cifra sus sistemas y exige un pago, no está robando datos en el sentido tradicional. Está atacando la disponibilidad. La tríada CIA lo deja claro: la confidencialidad, la integridad y la disponibilidad son propiedades de seguridad con el mismo peso. Sin embargo, la mayoría de las organizaciones siguen tratando la disponibilidad como una métrica de fiabilidad y la confidencialidad como la métrica de seguridad. Esa división deja una brecha que los atacantes explotan deliberadamente.
La guía del NIST sobre ciberseguridad en la Industria 4.0 expresa claramente el punto de integración: la planificación de la resiliencia moderna debe reunir a seguridad, operaciones de TI y continuidad del negocio, porque las amenazas no respetan los límites organizativos. Un incidente de ransomware es simultáneamente un evento de seguridad, un fallo de disponibilidad y una crisis de continuidad del negocio. Responder a él requiere las tres disciplinas trabajando desde el mismo manual de actuación.
Lo que encuentro sistemáticamente subestimado es cuánto impulsa el análisis de impacto en el negocio todo lo que viene después. Los equipos pasan semanas debatiendo si construir activo-activo o activo-pasivo, cuando la pregunta real es: ¿qué le cuesta realmente una hora de inactividad a este negocio? Responda eso con honestidad y la decisión de arquitectura suele tomarse sola. La comparación entre ISO 27001 y NIST merece la pena leerla si está intentando decidir qué marco usar como base para sus controles de disponibilidad, porque los dos tratan la disponibilidad de forma diferente en cuanto a alcance y requisitos de auditoría.
El siguiente paso práctico es sencillo: elija un proceso de negocio crítico, estime cuánto cuesta una hora de inactividad y asígnele un RTO. Ese único ejercicio le dirá más sobre sus requisitos reales de disponibilidad que cualquier página de marketing de tiempo de actividad de un proveedor.

Si su organización está trasladando los requisitos de disponibilidad a una implementación de ISO 27001, la Evaluación de Preparación para ISO 27001 de Ismscalculator traduce sus controles de seguridad, incluida la disponibilidad, en una estimación personalizada de coste y esfuerzo. También puede realizar una verificación gratuita de preparación en 2 minutos para ver en qué estado se encuentra su postura actual en los cuatro temas de control de ISO/IEC 27001:2022 antes de comprometerse con un plan de implementación completo.
Fuentes
- Dictionary
- Definición y significado de AVAILABILITY - Merriam-Webster
- Detectar y responder (proyecto NCCoE)