Das ISO 27001 Incident Management basiert auf fünf Annex A-Controls – 5.24 bis 5.28 – sowie der Meldepflicht für Mitarbeitende in 6.8. Ein konformes Programm benötigt ein namentlich benanntes Incident-Management-Team, eine dokumentierte Schweregrad-Matrix, mindestens ein getestetes Playbook sowie Nachweisdokumente mit einer nachvollziehbaren Chain of Custody. Auditoren wollen keine Richtlinien allein – sie wollen den Beweis, dass der Kreislauf von der Erkennung bis zur Lessons-Learned-Phase tatsächlich geschlossen wird.
Kurzfassung:
- Die Implementierung eines dokumentierten Incident-Management-Teams mit klaren Befugnissen und Rollenverteilung ist für eine wirksame ISO 27001-Compliance unerlässlich.
- Organisationen müssen einen messbaren Schweregrad-Klassifizierungsprozess etablieren, um eine zeitgerechte Entscheidungsfindung und Eskalation innerhalb festgelegter Fristen sicherzustellen.
- Die Erhebung von Nachweisen – einschließlich Logs und Memory-Snapshots – sollte vorab geplant und mit einer Chain of Custody versehen sein, um Datenverlust während der Incident Response zu verhindern.
- Regelmäßige Tabletop-Übungen und reale Vorfälle sind entscheidend, um den gesamten Kreislauf von der Erkennung bis zu den Lessons Learned zu testen – nicht nur die Richtliniendokumentation.
- Assessment-Tools können Lücken in der Incident-Management-Vorbereitung schnell identifizieren und die Einsatzbereitschaft vor einem tatsächlichen Vorfall sicherstellen.
Inhaltsverzeichnis
- Was umfasst das ISO 27001 Incident Management?
- Die fünf Incident-Management-Controls – Control für Control erklärt
- Wer leitet das Incident-Management-Team?
- Wie klassifiziert man den Schweregrad eines Vorfalls?
- Eindämmung, Beseitigung, Wiederherstellung und parallele Kommunikation
- Beweise sichern ohne die Response zu verlangsamen
- Vorfälle in ISMS-Verbesserungen umwandeln
- Was verlangen Auditoren bei der Prüfung?
- Wie ISMS Calculator die Incident-Management-Bereitschaft beschleunigt
- Autorenperspektive: Incident Management als iteratives Programm
- Starten Sie Ihre ISO 27001 Incident-Management-Bereitschaftsprüfung
- Quellen
Was umfasst das ISO 27001 Incident Management?
Informationssicherheits-Frameworks ziehen eine klare Linie zwischen einem „Ereignis" und einem „Vorfall". Ein Ereignis ist jedes beobachtbare Vorkommnis in einem System, Netzwerk oder Dienst. Die meisten Ereignisse sind Hintergrundrauschen: ein fehlgeschlagener Login, ein blockierter Port-Scan, ein markierter E-Mail-Anhang. Ein Vorfall ist ein Ereignis (oder eine Reihe von Ereignissen), das Vertraulichkeit, Integrität oder Verfügbarkeit mit realer Geschäftsauswirkung beeinträchtigt. Diese Unterscheidung ist entscheidend, weil sie bestimmt, wann der Incident-Management-Mechanismus aktiviert wird.
ISO/IEC 27001:2022 ordnet die Incident-Management-Anforderungen in Annex A, Controls 5.24 bis 5.28, mit einem unterstützenden Control bei 6.8 für die Meldepflicht von Mitarbeitenden. Diese fünf Controls stehen abseits der präventiven Controls, die den Großteil von Annex A dominieren – Zugangskontrolle, Kryptografie, Netzwerksegmentierung –, weil sie davon ausgehen, dass bereits etwas schiefgelaufen ist. Präventive Controls versuchen, den Brand zu verhindern. Incident-Management-Controls geben vor, was zu tun ist, sobald Rauch im Raum ist.
Das ist eine bewusste strukturelle Entscheidung. Ein Firewall-Regelwerk und ein Incident-Playbook lösen unterschiedliche Probleme: Das eine reduziert die Wahrscheinlichkeit einer Kompromittierung, das andere regelt, was passiert, wenn die Wahrscheinlichkeit nicht hält. Organisationen, die Incident Management als Erweiterung ihrer technischen Controls behandeln, neigen dazu, Playbooks zu schreiben, die niemand befolgt – weil die Controls wie Security-Architektur statt wie ein operatives Runbook klingen.
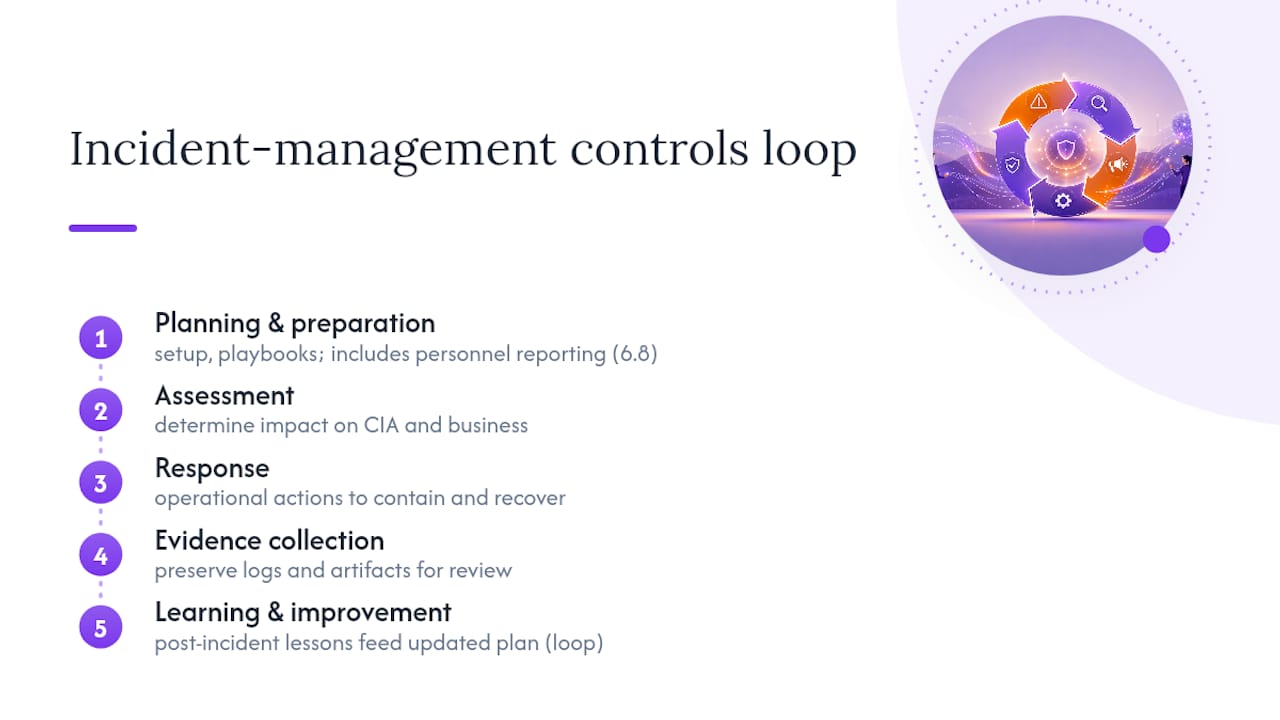
Die fünf Controls bilden einen Kreislauf, keine Checkliste. Planung und Vorbereitung fließen in die Bewertung, die Bewertung in die Response, die Response in die Beweissicherung, und die Beweissicherung in das Lernen – das wiederum den Plan aktualisiert. Praxisleitfäden zum Incident-Management-Control-Set beschreiben diesen Kreislauf als das, was Auditoren tatsächlich prüfen – häufig durch die Nachvollziehung eines realen Vorfalls oder einer Tabletop-Übung anstatt durch isoliertes Lesen von Dokumenten. Ein Ordner voller Richtlinientexte ohne Nachweis, dass der Kreislauf jemals durchlaufen wurde, ist der häufigste Befund in Überwachungsaudits.
Die fünf Incident-Management-Controls – Control für Control erklärt
Jeder Control entspricht einer bestimmten Phase des Incident-Lifecycles und erzeugt ein spezifisches Artefakt, das ein Auditor einsehen möchte. Das Artefakt wegzulassen – selbst wenn die zugrundeliegende Aktivität stattgefunden hat – ist funktional gleichbedeutend mit dem Weglassen des Controls.
5.24, Incident-Management-Planung und -Vorbereitung. Dieser Control verlangt eine dokumentierte Richtlinie, die definiert, was als Vorfall gilt, wer die Befugnis hat, einen solchen auszurufen, und wie die Organisation reagieren wird. Er bildet das Fundament, auf dem alles andere aufbaut.
- Ein namentlich benanntes Incident-Management-Team (IMT) mit definierten Rollen
- Schriftliche Playbooks für häufige Szenarien (Ransomware, Datenpanne, Denial of Service, Missbrauch durch Insider)
- Kommunikationskanäle und Eskalationswege, einschließlich Kontaktmöglichkeiten außerhalb der Geschäftszeiten
- Vorab genehmigte Vorlagen für interne Updates, Behördenmeldungen und Kundenkommunikation
5.25, Bewertung und Entscheidung. Sobald etwas gemeldet wird, muss schnell entschieden werden, ob es sich um einen echten Vorfall handelt und wie schwerwiegend er ist. Dieser Control fordert eine reproduzierbare Klassifizierungsmethode – keine situative Ermessensentscheidung.
- Das auslösende Ereignis mit Zeitstempel und Quelle protokollieren
- Eine Schweregradklassifizierung anwenden (ausführlich weiter unten erläutert)
- Entscheiden, ob ein Vorfall offiziell ausgerufen wird
- Die Entscheidung und die benötigte Zeit dokumentieren
5.26, Response. Dies ist der operative Kern: das Problem eindämmen, die Ursache beseitigen, den Normalbetrieb wiederherstellen und alle Beteiligten durchgehend informiert halten. Auditoren erwarten zu sehen, dass Eindämmungsmaßnahmen nicht auf eine vollständige Ursachenanalyse gewartet haben. In den ersten Stunden zählt Geschwindigkeit mehr als Vollständigkeit.
5.27, Lernen aus Vorfällen. Jeder abgeschlossene Vorfall sollte eine kurze Nachbewertung erzeugen: was passiert ist, warum, und was sich ändern wird. Dieser Control entscheidet darüber, ob ein Programm an Reife gewinnt oder stagniert. Organisationen, die diesen Schritt überspringen, durchleben denselben Vorfall – manchmal mit derselben Ursache – ein Jahr später erneut.
5.28, Beweissicherung. Logs, Screenshots, Memory-Captures und Kommunikationsaufzeichnungen benötigen eine dokumentierte Chain of Custody ab dem Zeitpunkt ihrer Erfassung. Das gilt auch dann, wenn zum Zeitpunkt des Vorfalls ein Rechtsstreit unwahrscheinlich erscheint – denn diese Annahme erweist sich im Nachhinein häufig als falsch.
Der Wortlaut der Klauseln in der Ausgabe von 2022 macht bewusst keine genauen Vorgaben zu Tools oder Formaten. Diese Flexibilität ist ein Vorteil für Organisationen, die bereits ein reifes IT-Service-Management betreiben, und eine Falle für solche, die „flexibel" als „optional" interpretieren. Der Annex A-Controls-Leitfaden von Ismscalculator zeigt, wie diese fünf Controls mit dem Rest von Annex A zusammenhängen, wenn Sie die größere Übersicht benötigen.
Wer leitet das Incident-Management-Team?
Ein IMT, das nur in einem Organigramm existiert, ist schlimmer als gar kein IMT – denn es gibt Auditoren ein Dokument, das sie auseinandernehmen können. Das Team benötigt namentlich benannte Personen, definierte Befugnisse und einen dokumentierten Übergabeprozess für den Fall, dass der primäre Ansprechpartner nicht erreichbar ist.
Ein funktionierendes IMT umfasst typischerweise:
- Incident Commander — verantwortet die Entscheidung, einen Vorfall auszurufen, zu eskalieren oder zu schließen, und koordiniert während der aktiven Response alle anderen Rollen
- Technical Lead — leitet die Eindämmungs- und Beseitigungsarbeiten über alle Systeme hinweg und zieht bei Bedarf Fachingenieure hinzu
- Communications Lead — entwirft und genehmigt interne Updates, Kundenbenachrichtigungen und Pressemitteilungen, bevor diese versendet werden
- Rechts- oder Compliance-Vertreter — entscheidet, wann externe Anwälte oder forensische Spezialisten einbezogen werden, und überwacht behördliche Meldepflichten
- HR- oder Personalvertreter — bearbeitet Fälle mit Bezug zu Insider-Bedrohungen, Mitarbeiterfehlverhalten oder disziplinarischen Folgemaßnahmen
Befugnisse sind der Teil, den Organisationen am häufigsten unzureichend dokumentieren. Darf der Technical Lead einen Produktionsserver isolieren, ohne zuvor ein Change-Management-Ticket zu erstellen? Darf der Incident Commander eine Kundenbenachrichtigung autorisieren, bevor die Rechtsabteilung zugestimmt hat, wenn Geschwindigkeit wichtiger ist als Perfektion? Diese Antworten müssen im Plan selbst festgehalten sein – nicht im Gedächtnis von jemandem, der weiß, „wie wir das üblicherweise handhaben".
Dokumentieren Sie Befugnisübertragungen ebenso wie jeden anderen Control: namentlich benannte Person, Umfang der Befugnis, Datum des Inkrafttretens sowie eine Unterschrift oder ein Systemeintrag als Bestätigung. Ergänzen Sie dies durch Schulungsnachweise, aus denen hervorgeht, dass jedes IMT-Mitglied mindestens eine Tabletop-Übung in seiner Rolle absolviert hat. Auditoren verlangen beides, und ein Team mit Befugnissen, aber ohne Schulungsnachweise, wirkt fast genauso unvorbereitet wie eines ohne beides.
Wie klassifiziert man den Schweregrad eines Vorfalls?
Control 6.8 verlangt, dass Organisationen ihren Mitarbeitenden einen klaren, unkomplizierten Meldeweg für vermutete Sicherheitsereignisse bereitstellen. Wenn die Meldung drei Genehmigungen und ein Ticket in einem System erfordert, dessen Zugangsdaten niemand mehr kennt, werden Mitarbeitende nichts melden – und der gesamte Incident-Management-Kreislauf verhungert an der Quelle. Wirksame Kanäle umfassen einen dedizierten E-Mail-Alias, eine rund um die Uhr besetzte Telefon-Hotline und eine Integration in das Chat-Tool, das die Mitarbeitenden täglich verwenden.
Sobald eine Meldung eingeht, muss sie schnell triagiert werden. Eine zweidimensionale Schweregrad-Matrix – Geschäftsauswirkung auf einer Achse, Zuverlässigkeit der Meldung auf der anderen – gibt Respondern eine konsistente Methode, ohne jedes Mal die Logik neu erfinden zu müssen.
- Hohe Auswirkung, hohe Zuverlässigkeit → sofort ausrufen, vollständiges IMT aktivieren, Entscheidung innerhalb von 30 Minuten anstreben
- Hohe Auswirkung, geringe Zuverlässigkeit → an den Technical Lead zur raschen Validierung eskalieren, Entscheidung innerhalb von 2 Stunden
- Geringe Auswirkung, hohe Zuverlässigkeit → über standardmäßigen operativen Prozess abwickeln, protokollieren und überwachen
- Geringe Auswirkung, geringe Zuverlässigkeit → für Mustererkennung protokollieren, keine unmittelbare Eskalation erforderlich
Die Matrix erfüllt eine doppelte Funktion. Sie gibt Respondern einen Entscheidungsrahmen und liefert Auditoren ein sichtbares, zeitgestempeltes Protokoll darüber, wie schnell die Organisation von der Meldung zur Entscheidung gelangt ist – genau die Kennzahl, die Überwachungsaudits gerne unter die Lupe nehmen.
Praxistipp: Legen Sie Ihre Entscheidungszeitfenster fest, bevor Sie sie unter Druck benötigen. Eine Organisation, die „angemessen reagieren" schreibt statt „Tier-1-Vorfall innerhalb von 30 Minuten ausrufen", schafft sich Spielraum, eine langsame Reaktion im Nachhinein zu erklären – und gibt einem Auditor einen einfachen Befund.
Eindämmung, Beseitigung, Wiederherstellung und parallele Kommunikation
Die Response gemäß Control 5.26 hat vier sich überlappende Bestandteile, die nicht in strenger Reihenfolge ablaufen.
- Eindämmung — betroffene Systeme isolieren, verdächtigen Datenverkehr drosseln oder temporäre Zugriffsbeschränkungen anwenden, um die Ausbreitung zu stoppen, ohne die Ursache zwingend sofort zu beheben
- Beseitigung — Malware entfernen, die ausgenutzte Schwachstelle schließen, kompromittierte Zugangsdaten widerrufen und die zugrundeliegende Schwachstelle patchen
- Wiederherstellung — Systeme aus sauberen Backups wiederherstellen, Datenintegrität prüfen und Dienste in einer kontrollierten Reihenfolge wieder in Betrieb nehmen
- Kommunikation — läuft die gesamte Zeit parallel zur technischen Arbeit, nicht nachgelagert
Der Kommunikationsstrang ist der Bereich, an dem technisch solide Responses scheitern. Interne Updates müssen Führungskräfte und betroffene Teams in einem festen Rhythmus erreichen, auch wenn es nichts Neues zu berichten gibt – Schweigen wird als Kontrollverlust wahrgenommen. Externe Kommunikation – an Kunden, Partner oder Behörden – benötigt vorab abgestimmte Vorlagen, damit niemand unter Druck um 2 Uhr nachts eine Datenpannen-Benachrichtigung von Grund auf neu verfassen muss.
Praxistipp: Erstellen Sie Ihre Benachrichtigungsvorlagen für Behörden und Kunden in ruhigen Zeiten – lange vor einem Vorfall – und holen Sie vorab die rechtliche Freigabe für den Standardtext ein. Eine vorab genehmigte Vorlage unter Termindruck zu bearbeiten ist eine grundlegend andere Aufgabe, als eine Vorlage auf einem leeren Blatt zu schreiben, während Stakeholder warten.
Die Rollback-Planung gehört in die Beseitigungsphase – nicht als nachträglicher Gedanke. Wenn ein Patch eine Abhängigkeit bricht oder ein widerrufener Zugang ein legitimes Dienstkonto aussperrt, brauchen Sie einen getesteten Weg zurück zum vorherigen bekannt-sicheren Zustand. Für sektorspezifische Ablaufplanung zeigt der Incident-Response-Leitfaden von Ismscalculator für Banking-ISMS-Umgebungen, wie regulierte Unternehmen diese Übergabe strukturieren – die Grundlogik lässt sich mit geringen Anpassungen auf andere regulierte Sektoren übertragen. Das Playbook-Design profitiert generell davon, jeden Incident-Typ als eigenes Szenario zu behandeln statt eine generische Vorlage zu verwenden; operative Playbook-Leitlinien zur Incident Response unterstützen denselben Ansatz zugunsten szenariospezifischer Runbooks gegenüber einem einzigen Alles-abdeckenden Dokument.
Beweise sichern ohne die Response zu verlangsamen
Control 5.28 verlangt, dass Organisationen Beweise so identifizieren, erfassen, sichern und aufbewahren, dass diese später für Ermittlungen oder Behördenmeldungen verwendbar bleiben. Das ist eine Dokumentationsdisziplin, die über die technische Response hinausgeht – und leicht vernachlässigt wird, wenn die Priorität im jeweiligen Moment darin besteht, Systeme wieder online zu bringen.
Bei nahezu jedem Vorfall schützenswerte Beweise umfassen:
- System- und Anwendungslogs aus dem betroffenen Zeitraum, exportiert bevor die Rotation sie löscht
- Memory-Images oder forensische Snapshots von Systemen, bei denen eine aktive Kompromittierung vermutet wird
- Eine Zeitleiste der ergriffenen Maßnahmen – von wem, wann – einschließlich Eindämmungsentscheidungen
- Kopien der internen und externen Kommunikation, die während der Response versandt wurde
Eine Chain of Custody muss nicht aufwändig sein. Ein einfaches Protokoll – wer den Nachweis erfasst hat, wann, wo er gespeichert ist und wer seitdem darauf zugegriffen hat – genügt den meisten Auditoren, und es ist die Art von Artefakt, die der Ismscalculator-Leitfaden zu Nachweisarten für ISO 27001-Audits mit konkreten Vorlagen beschreibt.
Die eigentliche Spannung besteht zwischen Geschwindigkeit und Integrität. Das Wiederherstellen eines kompromittierten Servers aus einem Backup kann genau den Memory-Zustand zerstören, den ein forensischer Ermittler benötigen würde. Die Lösung ist eine einfache Regel, die vorab im Playbook verankert ist: Bei jedem Vorfall, der über einem bestimmten Schweregrad liegt, wird vor dem Löschen oder Neuaufbau eines Systems kurz innegehalten, um ein forensisches Image zu erstellen. Dieser einzelne Checkpoint – vorab festgelegt statt mitten im Vorfall ausgehandelt – verhindert die meisten beweiszerstörenden Fehler.
Vorfälle in ISMS-Verbesserungen umwandeln
Control 5.27 ist in der Beschreibung täuschend einfach und in der Umsetzung schwierig: den Vorfall nachbewerten, die Ursache finden, beheben, was ihn ermöglichte, und den Nachweis erbringen, dass die Behebung greift. Organisationen, die das als Formalität behandeln, schreiben eine einseitige Zusammenfassung und gehen weiter. Organisationen, die es ernst nehmen, nutzen es, um echten ISMS-Wandel voranzutreiben.
Eine Post-Incident-Review, die einer Auditprüfung standhält, umfasst:
- Was passiert ist – in einer sachlichen Zeitleiste ohne Wertungen
- Die Grundursache, klar von beitragenden Faktoren unterschieden
- Korrektur- und Vorbeugungsmaßnahmen, jeweils mit einem namentlich benannten Verantwortlichen und einer Frist
- Welche bestehende Risikobehandlung oder Richtlinie der Vorfall als unzureichend entlarvt hat
Der Schritt, den die meisten überspringen, ist der letzte. Ein Vorfallsbericht, der nie das Risikoregister oder die Richtlinien berührt, ist eine Geschichte – kein ISMS-Input. Auditoren suchen gezielt nach der Verbindung zwischen „das ist passiert" und „hier ist, was sich in unseren dokumentierten Controls infolgedessen geändert hat". Ohne diese Verbindung leistet selbst ein gut geschriebener Post-Mortem keinen Beitrag zu Ihrer Zertifizierung.
Was verlangen Auditoren bei der Prüfung?
Zertifizierungsstellen akzeptieren selten einen Richtlinienordner als ausreichenden Nachweis dafür, dass die Incident-Management-Controls funktionieren. In der gängigen Praxis von Überwachungsaudits wird ein realer Vorfall aus dem vergangenen Zyklus durchgegangen oder spontan eine Tabletop-Übung durchgeführt, um zu prüfen, ob das IMT sein eigenes Playbook tatsächlich kennt.
Ein sinnvoller Testzyklus sieht jährlich eine vollständige Tabletop-Übung vor, die ein realistisches Szenario wie Ransomware oder eine Drittanbieter-Datenpanne abdeckt, ergänzt durch gezielte Simulationen für Risikobereiche mit höherem Schutzbedarf, die im Rahmen der Risikobewertung identifiziert wurden. Aus jeder Übung aufzubewahrende Nachweise:
- Das schriftliche Szenario und die Übungsziele
- Anwesenheitsliste und Rollenzuweisungen der Teilnehmer
- Aufzeichnungen zu getroffenen Entscheidungen und benötigter Zeit
- Eine nachverfolgte Liste der durch die Übung aufgedeckten Korrekturmaßnahmen mit Umsetzungsstatus
Wenn Auditoren Stichproben anfordern, verlangen sie typischerweise einen abgeschlossenen Vorfallsbericht, der den vollständigen Kreislauf von der Erkennung bis zu den Lessons Learned zeigt, einen Chain-of-Custody-Nachweis aus einer echten oder simulierten Beweissicherung sowie Schulungsnachweise, die belegen, dass IMT-Mitglieder ihre zugewiesenen Rollen geübt haben. Eine praxistaugliche Incident-Response-Plan-Vorlage kann helfen, diese Artefakte zu strukturieren, wenn Sie von Grund auf aufbauen. Die Zertifizierungs-Checkliste von Ismscalculator zeigt, wo diese Nachweisarten in den umfassenderen 80-Schritte-Pfad zur Zertifizierung passen.
Eine Sache, die ISO bewusst nicht tut: Fristen für Datenpannen-Meldungen festlegen. Diese ergeben sich aus den jeweiligen Rechtsordnungen, in denen die Organisation tätig ist – staatliche Datenpannen-Meldepflichten in den USA, HIPAA für Gesundheitsdaten, SEC-Regeln für börsennotierte Unternehmen. Die Incident-Controls von ISO regeln den internen Prozess, aber die externe Uhr läuft unabhängig davon – und die Abstimmung Ihrer internen Entscheidungszeitleiste mit diesen regulatorischen Fristen bleibt vollständig Ihrer eigenen Organisation überlassen.
Wie ISMS Calculator die Incident-Management-Bereitschaft beschleunigt
Die oben genannten Artefakte von Grund auf zu erstellen – Schweregrad-Matrix, Playbooks, Nachweisvorlagen – ist der Punkt, an dem die meisten Implementierungszeitpläne ins Stocken geraten. Ein maßgeschneidertes Readiness-Assessment identifiziert genau, welche der Controls 5.24 bis 5.28 bereits über funktionierende Dokumentation verfügen und welche nur Platzhaltertext enthalten – bevor ein Auditor die Lücke für Sie findet.
Das Reifegradassessment von Ismscalculator über die vier Annex A-Kontrollthemen bewertet das Incident Management gemeinsam mit dem Rest Ihres ISMS, sodass Sie sehen, ob es Ihr schwächster Bereich oder eine relative Stärke ist. Sobald Lücken kartiert sind, ermöglichen die Gantt- und Zeitplantools der Plattform eine Priorisierung der Arbeit: zuerst die Schweregrad-Matrix, dann die IMT-Dokumentation, dann ein getestetes Playbook, Nachweisvorlagen parallel dazu.
Der kostenlose Bereitschafts-Check dauert etwa zwei Minuten und liefert einen Vergleichswert gegenüber Organisationen ähnlicher Größe und Branche – nützlicher Kontext, wenn Sie entscheiden müssen, ob Ihr aktueller Tabletop-Rhythmus zu dünn oder im Branchenvergleich angemessen ist. Compliance-Verantwortliche mit wenig Zeit nutzen ihn häufig als ersten Überblick und vertiefen sich anschließend in die domänenspezifischen Details, sobald sie wissen, wo die eigentlichen Lücken liegen.
Autorenperspektive: Incident Management als iteratives Programm
Die Reifefalle, die ich am häufigsten beobachte, ist kein fehlender Control. Es ist eine Implementierung, die vollständig für das Audit gebaut wurde – und nicht für den Ernstfall. Teams schreiben eine mustergültige 5.24-Richtlinie, führen eine Tabletop-Übung in der Woche vor dem Assessor-Besuch durch und lassen das Playbook dann ein Jahr lang unangetastet. Das besteht die Zertifizierung. Einen echten Ransomware-Angriff übersteht es nicht.
Fangen Sie kleiner und ehrlicher an. Erstellen Sie eine Schweregrad-Matrix mit echten Schwellenwerten, benennen Sie ein echtes IMT mit echten Befugnissen, und testen Sie ein Playbook so lange unter Druck, bis die Beteiligten es ohne das Dokument vor sich ausführen können. Alles andere – Nachweisvorlagen, Benachrichtigungsworkflows, regulatorisches Mapping – wird einfacher, sobald dieser Kernkreislauf unter Stress funktioniert.
Behandeln Sie jeden Vorfall – echt oder simuliert – als Input für das ISMS statt als Problem, das man schließt und vergisst. Das ist der Unterschied zwischen einem Programm, das seinen ersten echten Test besteht, und einem, das nur seinen Audit überlebt hat.
— Martin
Starten Sie Ihre ISO 27001 Incident-Management-Bereitschaftsprüfung
Die fünf Incident-Management-Controls von Grund auf aufzubauen kostet in der Regel wochenlange Abstimmung zwischen Compliance, IT und Recht, bevor überhaupt klar ist, was tatsächlich fehlt. Das ISO 27001 Readiness Assessment von Ismscalculator beschleunigt diesen Prozess, indem es Ihre aktuelle Dokumentation direkt gegen 5.24 bis 5.28 abgleicht und genau aufzeigt, wo Ihre Schweregrad-Matrix, IMT-Befugnisnachweise oder Nachweisvorlagen unzureichend sind.

Das Assessment dauert etwa zwei Minuten und liefert einen maßgeschneiderten Lückenbericht, einen Vergleich mit dem Referenzmodell sowie eine Zeitschätzung für die Behebung der festgestellten Lücken. Sie erhalten einen PDF-Bericht, den Sie mit der Unternehmensleitung oder einem Auditor teilen können, eine priorisierte Maßnahmenliste sowie die Möglichkeit, Ihre Ergebnisse zu speichern und mit einer späteren Schätzung nach Behebung der Lücken zu vergleichen. Wenn Sie lieber zuerst das vollständige Toolkit erkunden möchten – einschließlich des Gantt-basierten Implementierungsplaners – ist die ISMS Calculator-Plattform der richtige Ausgangspunkt.
Quellen
- ISO/IEC 27001:2022 – Informationssicherheits-Managementsysteme
- ISO 27001 Incident Management Controls für Response und Dokumentation